
Beispielanruf · Deutsch
KI, die arbeitet.
In Ihrem Unternehmen.
Ein KI-Automatisierungsunternehmen aus Hamburg. Wir bringen KI auf drei Wegen in Ihr Unternehmen.
Der Unternehmensfilm · 1 Min 48 s
Das ist AuraMind.
Ein KI-Automatisierungsunternehmen aus Hamburg.
Eine Woche in einer Kfz-Werkstatt: AuraMind Voice nimmt das Telefon ab, Ihre eigene KI beantwortet die Fragen des Teams, und Automationen übernehmen die Routine.
Einen Beispielanruf entdeckenKfz-Werkstatt · Salon · Immobilien+
Beispielszenarien
„Kann ich einen Termin zur Bremsenprüfung buchen?“
Der Agent versteht das Anliegen, schlägt einen Termin vor und bestätigt ihn erst nach Zustimmung.
Beispiel zur Veranschaulichung. Es wird kein echter Termin angelegt.
Drei Wege.
Ein Unternehmen.
1 AuraMind Voice nimmt Ihr Telefon ab. 2 Ihre eigene KI läuft auf Ihrem eigenen Server. 3 Automationen arbeiten für Ihr Team. Software wird drum herum gebaut.
Die drei Teile entdeckenGeben Sie Ihren KI-Werkzeugen
eine sinnvolle Aufgabe.
Werkzeug wählen. Beispiel ansehen. Verstehen, was wir für Ihr Team einrichten.
OpenClaw
Open-Source-KI-Assistent, der auf Ihren eigenen Geräten läuft.
Aus einem Briefing wird ein Content-Entwurf.
Ein Agent kann freigegebene Informationen sammeln und einen Entwurf vorbereiten. Ihr Team entscheidet, was veröffentlicht wird.
 Referenzbild vergrößern
Beispielablauf · Beispieldaten
Briefing vorgeben
Drei Beiträge für unsere neue Leistung vorbereiten. Nur die freigegebenen Produktnotizen verwenden.
Grenzen festlegen
Produktnotizen einlesen. Markenrichtlinien zuordnen. Die Veröffentlichung bleibt bei einer Person.
Entwurf vorbereiten
Der Agent erstellt einen Content-Entwurf und markiert noch zu prüfende Informationen.
Vor Veröffentlichung prüfen
Drei Beitragsentwürfe, Quellen und offene Fragen landen in Ihrer Prüfung. Dieses Beispiel veröffentlicht nichts.
- Läuft auf
- Selbst gehostet: Ihr Rechner, Server oder private Cloud.
- Verbindet sich mit
- WhatsApp, Slack, Telegram und die Werkzeuge, die Sie erlauben.
- Eine Person gibt frei
- Bevor etwas veröffentlicht oder gesendet wird.
- Grenze
- Werkzeuge handeln auf dem Host, wenn keine Sandbox eingerichtet ist.
Hermes Agent
Open-Source-Agent für Rechercheaufgaben, der auf Ihrem eigenen Rechner läuft.
Recherche liefern, die Sie prüfen können.
Einen wiederkehrenden Rechercheauftrag klar eingrenzen. Einen Bericht mit Quellen, Unsicherheiten und nächstem Schritt erhalten.
 Referenzbild vergrößern
Beispielablauf · Beispieldaten
Gezielt fragen
Änderungen bei den bereits beobachteten Lieferanten zusammenfassen.
Quellen auswählen
Die vereinbarte Quellenliste nutzen. Datum und Original-Link bei jedem Fund erhalten.
Bericht zusammenstellen
Relevante Änderungen ordnen und fehlende oder widersprüchliche Informationen markieren.
Entscheidung treffen
Ihr Team prüft die Nachweise und entscheidet, ob weitere Schritte nötig sind.
- Läuft auf
- Selbst gehostet unter Linux, macOS oder Windows.
- Verbindet sich mit
- Chat, E-Mail, Websuche, MCP-Werkzeuge und Ihr gewähltes Modell.
- Eine Person gibt frei
- Eine Person prüft den Bericht, bevor jemand handelt.
- Grenze
- Die Freigabe gilt für riskante Befehle, nicht für jede Aktion.
Grok Bot / Grok Build
Gehosteter Agent von SpaceXAI mit eigenem Cloud-Rechner; Grok Build ist das zugehörige Programmierwerkzeug.
Nachfassen abgeben. Freigabe behalten.
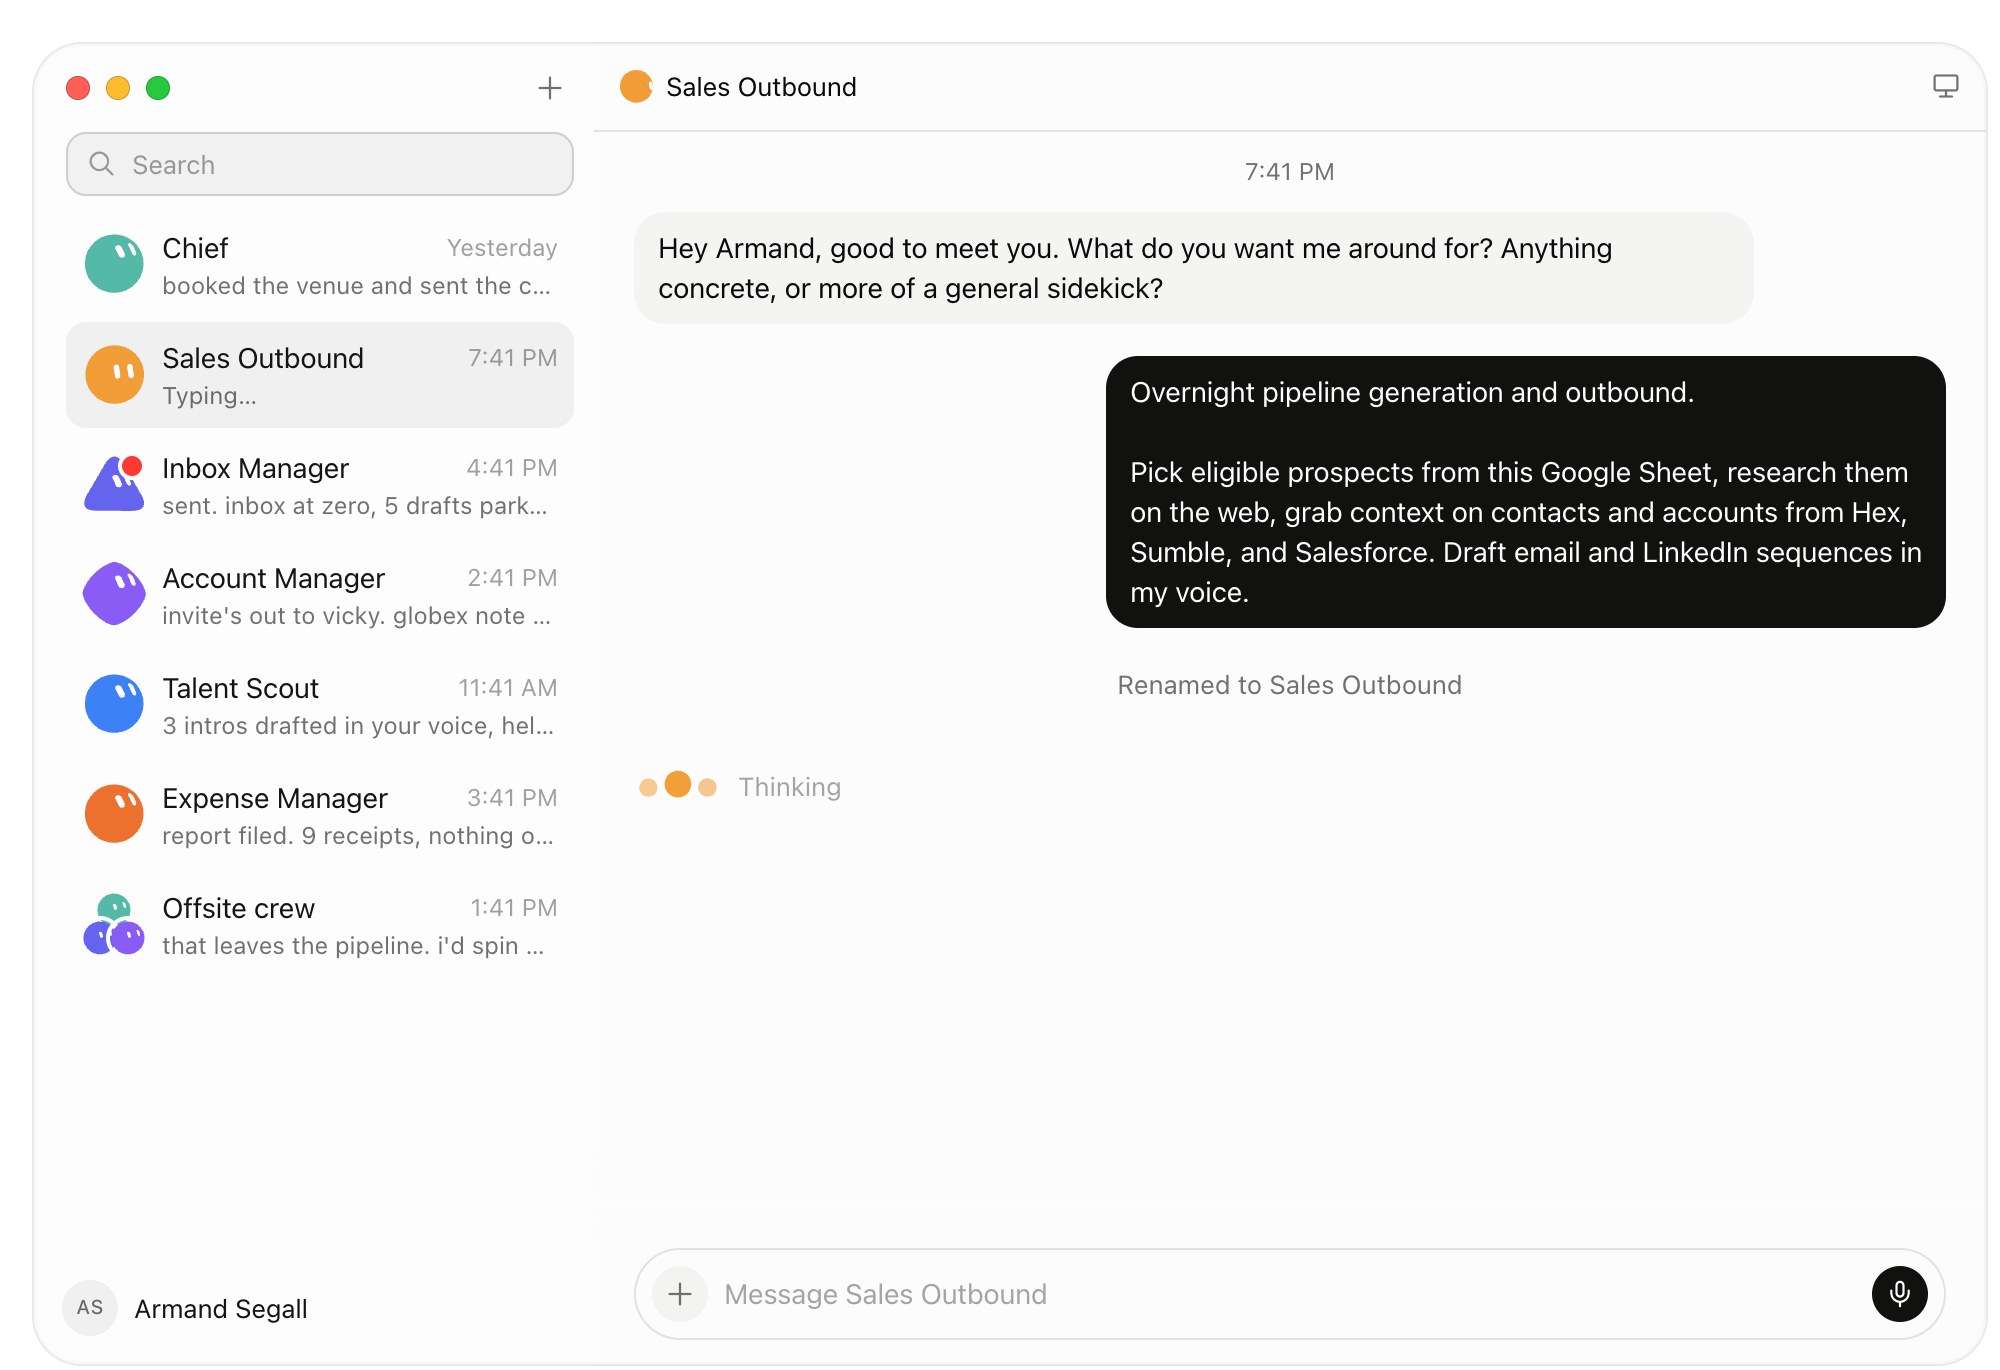
Grok Bot ist ein gehosteter Teamkollege von SpaceXAI, vormals xAI. Er bekommt einen eigenen Cloud-Rechner, meldet sich in den von Ihnen erlaubten Werkzeugen an, erledigt eine mehrstufige Aufgabe und meldet sich zur Freigabe zurück. Grok Build ist der Programmieragent im Terminal, der interne Werkzeuge baut und repariert.
 Referenzbild vergrößern
Beispielablauf · Beispieldaten
Dem Bot eine Aufgabe geben
Offene Angebote der letzten Woche nachfassen. Antworten entwerfen, nicht senden.
Werkzeuge erlauben
Der Bot meldet sich auf seinem eigenen Cloud-Rechner im gemeinsamen Postfach und im CRM an. Das Senden bleibt ausgeschaltet.
Liste abarbeiten
Er liest jeden Verlauf, prüft den Kundendatensatz und entwirft eine Antwort zur Prüfung.
Vor dem Senden freigeben
Entwürfe und Datensatzänderungen warten auf eine Person. Dieses Beispiel sendet nichts.
- Läuft auf
- Grok Bot: der Cloud-Rechner des Anbieters, nicht selbst gehostet. Grok Build: Ihr Rechner, mit Modellaufrufen an die Cloud des Anbieters. Apache-2.0.
- Verbindet sich mit
- Die Postfächer, CRMs und Websites, in denen sich der Bot anmelden darf; diese geschäftlichen Zugänge liegen auf diesem Cloud-Rechner. Grok Build: Ihr Repository.
- Eine Person gibt frei
- Der Bot meldet sich zurück, wenn er eine Freigabe braucht. Eine Person prüft jede Änderung von Grok Build vor der Freigabe.
- Grenze
- Grok Bot ist eine Beta für SuperGrok- und Cursor-Abonnenten. Nach dem Upload-Vorfall von Grok Build im Juli 2026 werden Telemetrie- und Upload-Einstellungen geprüft, bevor ein Kunden-Repository verbunden wird.
Meta Muse
Metas Agent für kleine Unternehmen auf Facebook und Instagram.
Ein Wochenziel setzen. Das Ergebnis freigeben.
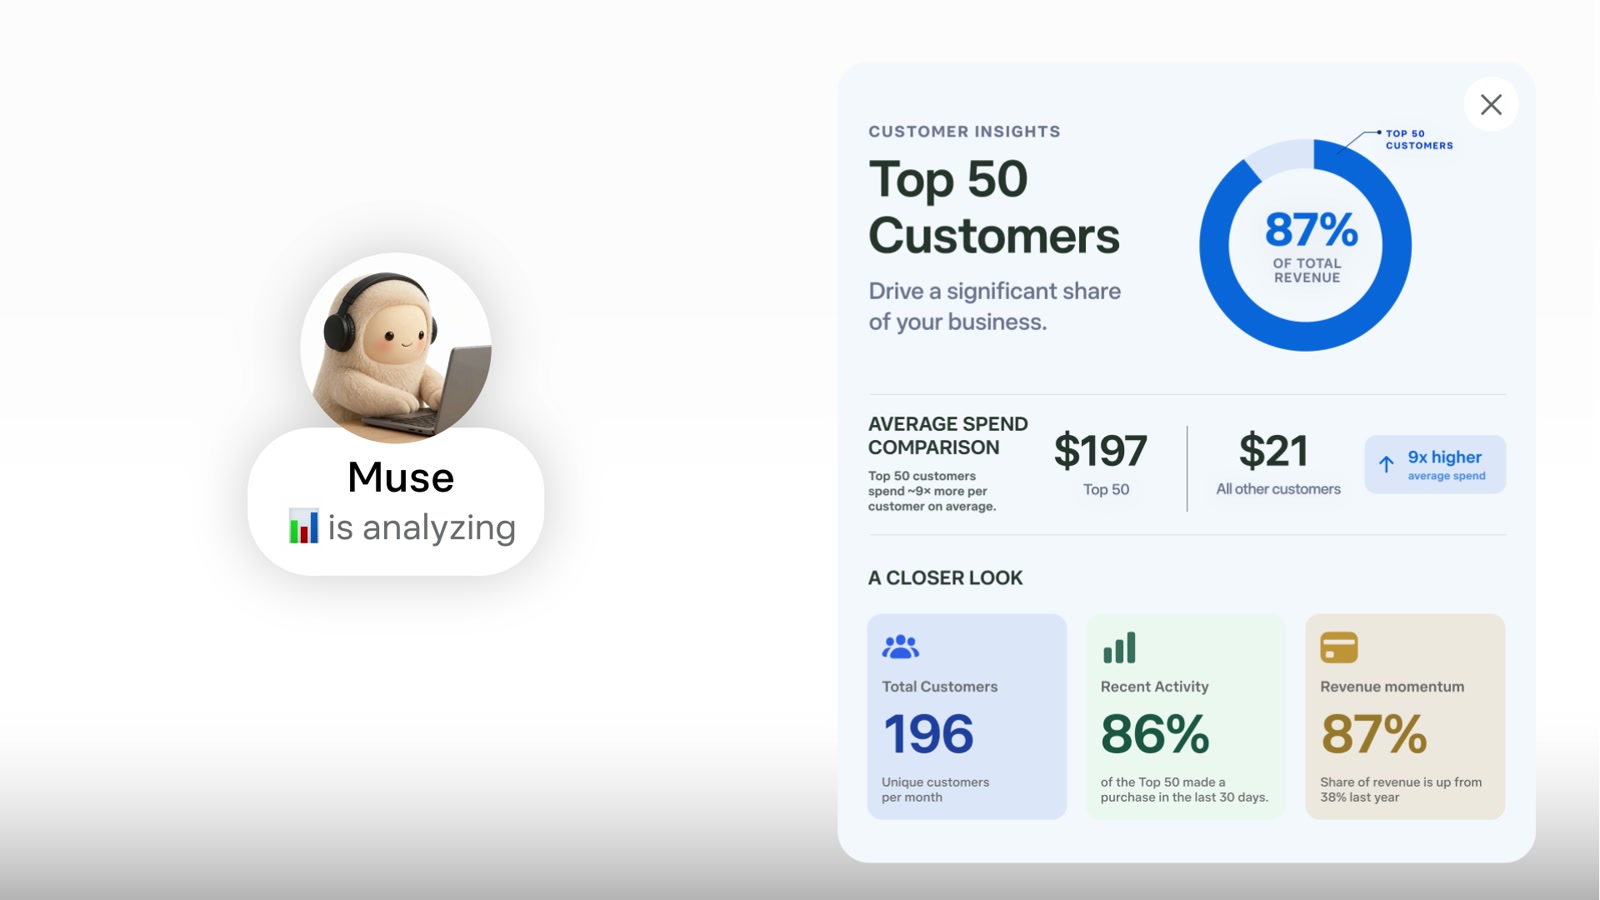
Ein persönlicher Agent, der über längere Zeit an einem Ziel arbeitet. Muse for Small Business verbindet Facebook- und Instagram-Unternehmenskonten, Meta-Werbekonten und Werkzeuge wie Shopify, Intuit QuickBooks, Stripe, Slack, Notion, Canva, Asana und Zoom. In Metas eigenen Worten: „nothing publishes, sends, or spends without your approval“, also nichts wird ohne Ihre Freigabe veröffentlicht, gesendet oder ausgegeben.
 Referenzbild vergrößern
Beispielablauf · Beispieldaten
Ziel festlegen
Beiträge und Anzeigen der letzten Woche für unseren Shop auswerten. Die Kampagne für nächste Woche entwerfen.
Konten verbinden
Facebook- und Instagram-Unternehmenskonten, das Meta-Werbekonto und Shopify, jeweils nur mit dem Zugriff, den die Aufgabe braucht.
Über Zeit arbeiten
Muse arbeitet auf seiner eigenen Cloud-Maschine an dem Ziel und bereitet einen Kampagnenentwurf mit den Zahlen dahinter vor.
Inhaber gibt frei
Nichts wird veröffentlicht, gesendet oder ausgegeben, bis der Inhaber freigibt. Dieses Beispiel veröffentlicht nichts.
- Läuft auf
- Metas Cloud, eine virtuelle Maschine pro Nutzer. Nicht selbst gehostet.
- Verbindet sich mit
- Facebook- und Instagram-Unternehmenskonten, Meta-Werbekonten, Shopify, QuickBooks, Stripe, Slack, Notion, Canva, Asana und Zoom.
- Eine Person gibt frei
- Metas Formulierung: Nichts wird ohne Ihre Freigabe veröffentlicht, gesendet oder ausgegeben.
- Grenze
- Bei dieser Prüfung nur USA und Kanada, nicht Deutschland. Anfragen werden für das Modelltraining genutzt, sofern nicht abgeschaltet.
Claude Code
Anthropics Programmier-Agent zum Bauen und Ändern von Software.
Ein Werkzeug für eine echte Aufgabe bauen.
Eine wiederkehrende Tabellenaufgabe in eine geprüfte Softwareänderung umsetzen – mit abgestimmtem Plan und Tests.
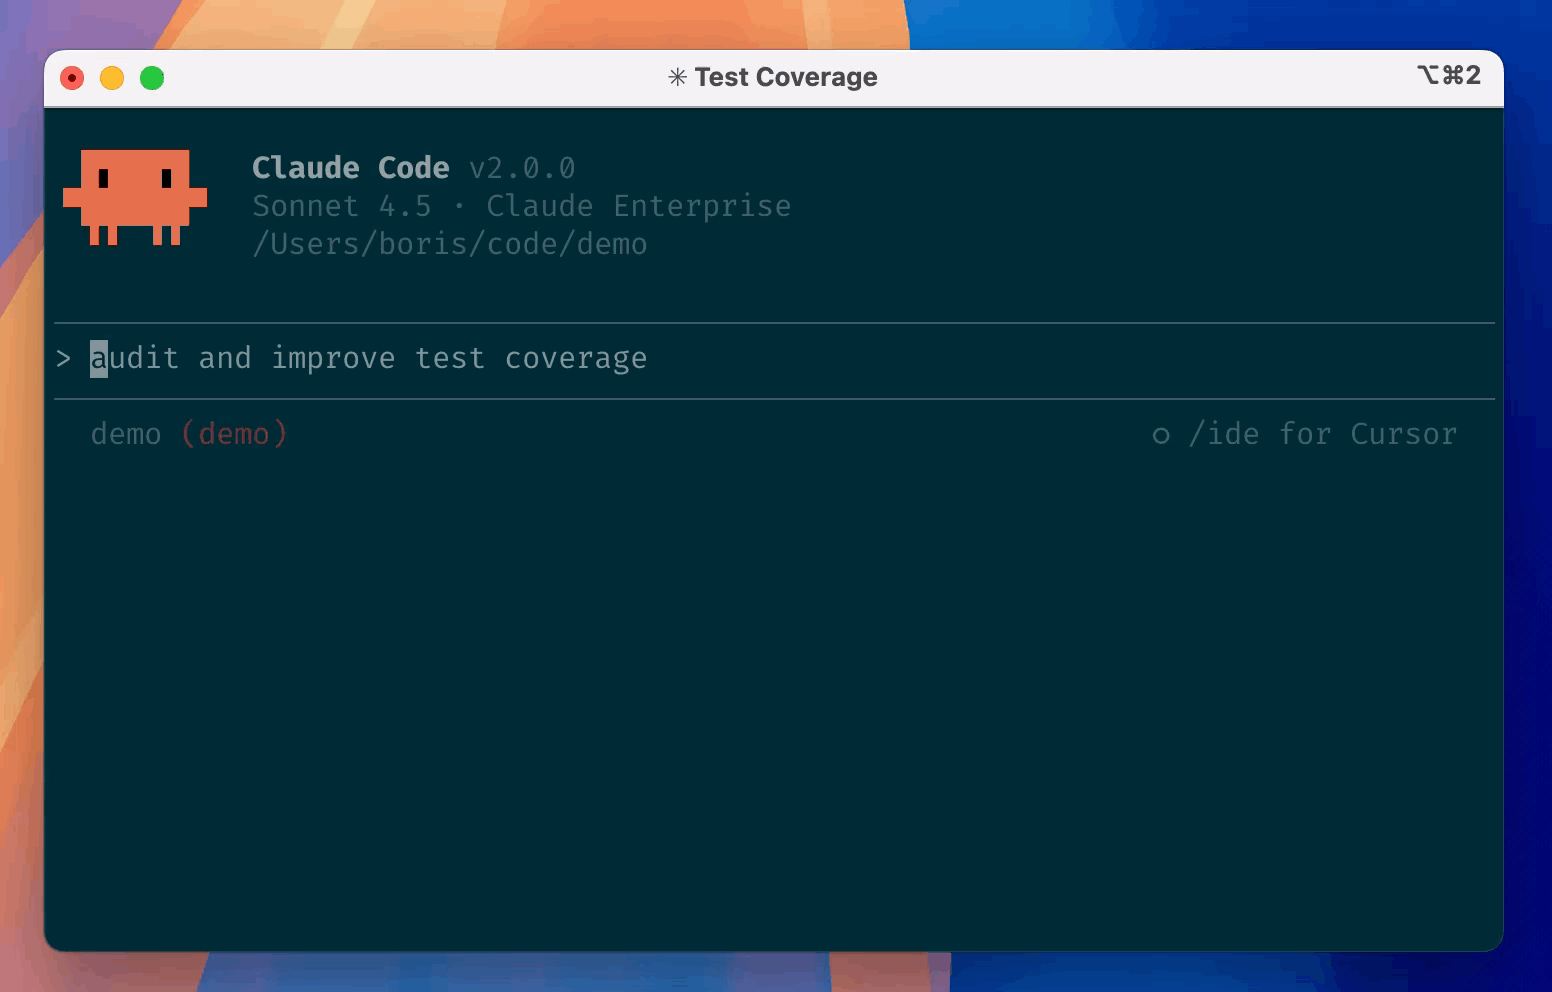 Referenzbild vergrößern
Beispielablauf · Beispieldaten
Aufgabe beschreiben
Unsere wöchentlichen Bestellexporte in einer Prüfansicht zusammenführen.
Änderung planen
Projekt prüfen und Eingaben, Ausgaben sowie Fehlerbehandlung festlegen.
Bauen und testen
Codeänderungen vorbereiten und vereinbarte Prüfungen mit Beispieldateien ausführen.
Ergebnis prüfen
Änderung prüfen, Ablauf ausprobieren und Veröffentlichung separat freigeben.
- Läuft auf
- Ihr Rechner oder der Browser. Modellaufrufe gehen an Anthropic.
- Verbindet sich mit
- Ihr Repository, Tests, GitHub und MCP-Werkzeuge.
- Eine Person gibt frei
- So eingestellt, dass es vor Änderungen und Befehlen fragt. Eine Person prüft die Änderung.
- Grenze
- Rücknahme gilt für Dateien, nicht für externe Systeme. Bezahlter Tarif nötig.
Codex / Automations
OpenAIs Programmier-Agent plus geplante Aufgaben, die von selbst laufen.
Fehler finden. Korrektur prüfen.
Einen fehlerhaften internen Ablauf untersuchen, gezielt korrigieren und Testergebnisse zeigen. Automations führen Aufgaben dann nach Zeitplan oder bei unterstützten App-Ereignissen aus: ein täglicher Kurzbericht, eine Wochenzusammenfassung, eine Bereinigung. Eine Person prüft jedes Ergebnis.
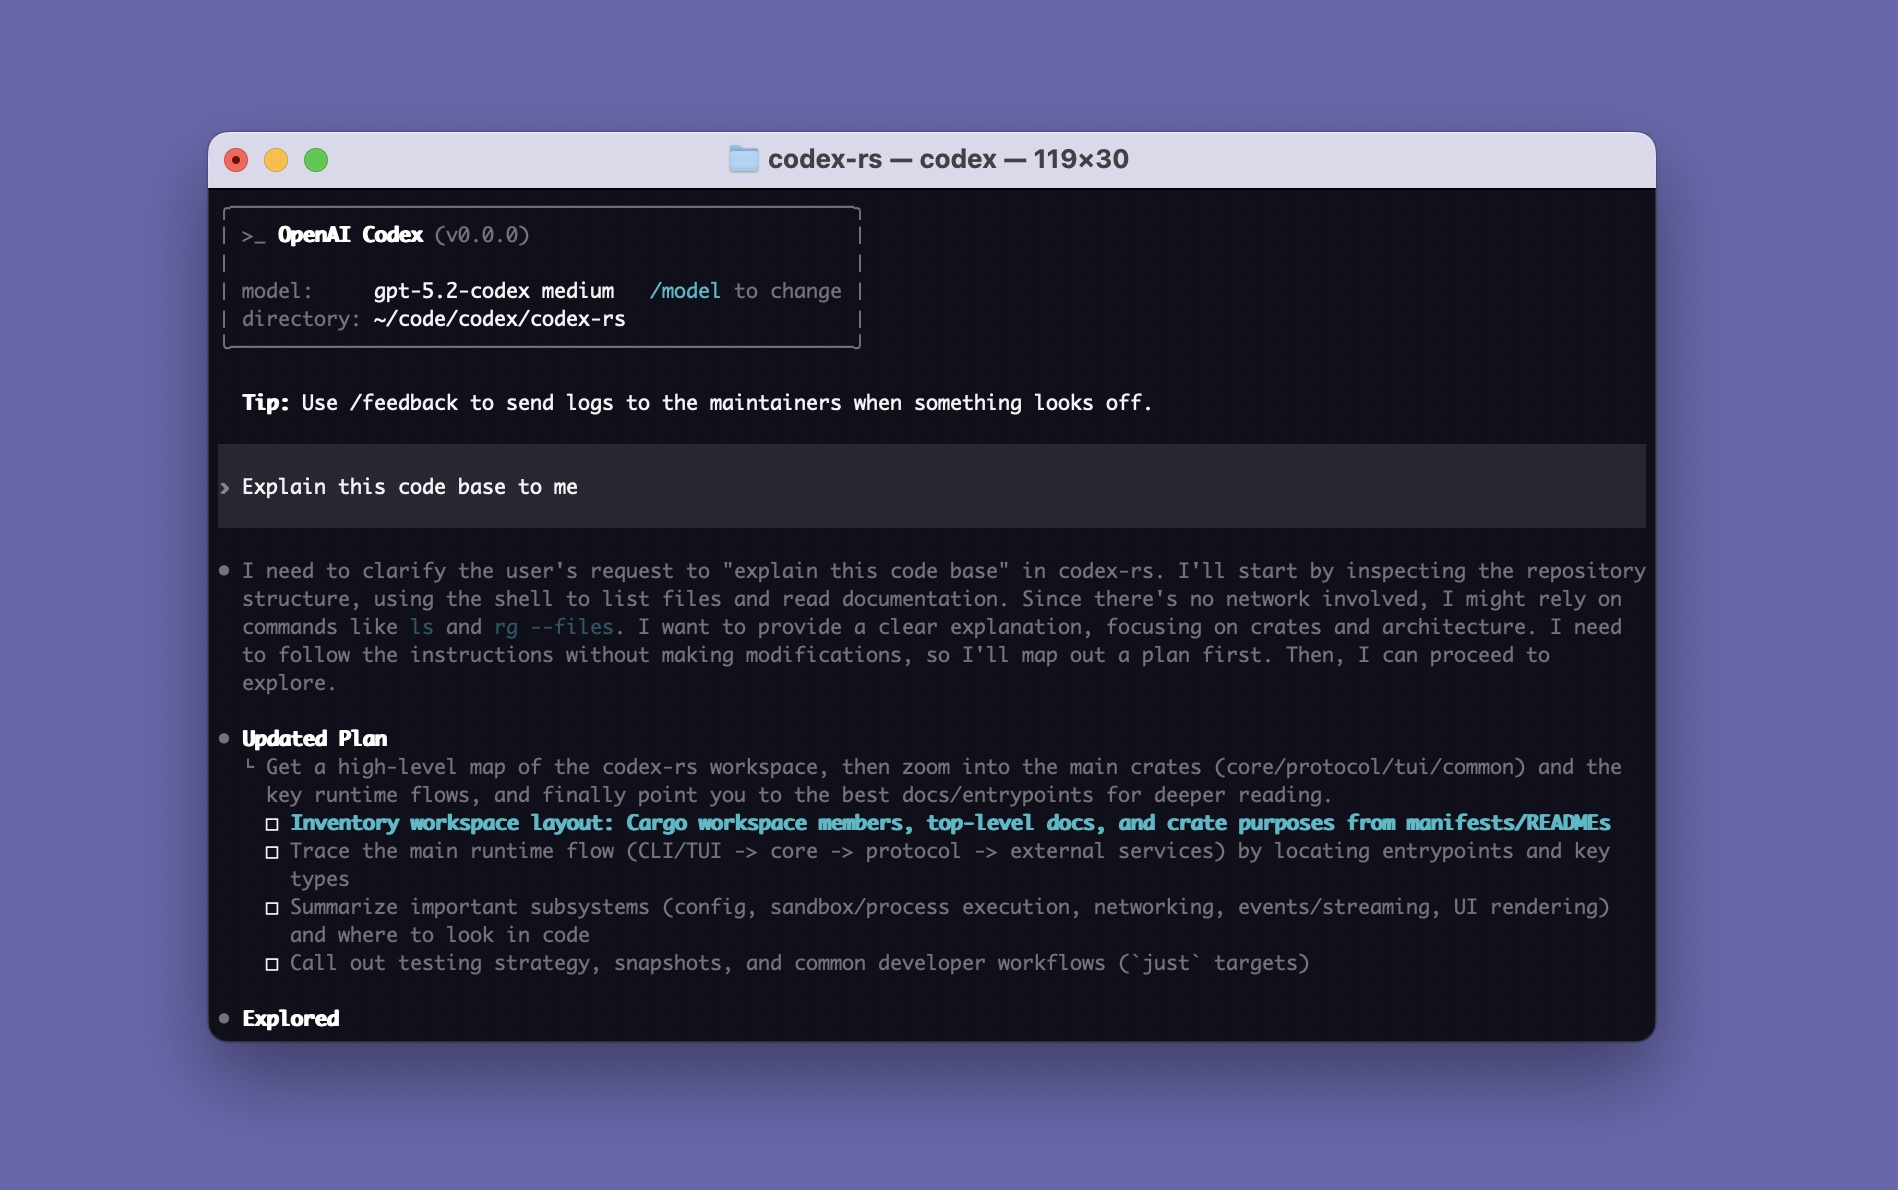 Referenzbild vergrößern
Beispielablauf · Beispieldaten
Fehler zeigen
Unser Import erzeugt doppelte Kontakte, wenn eine Datei erneut verarbeitet wird.
Nachstellen und korrigieren
Importpfad mit sicheren Beispieldatensätzen untersuchen, gezielt korrigieren und die Prüfungen einschließlich Wiederholung erneut ausführen.
Nachkontrolle planen
Eine Automation wiederholt die Importprüfung jeden Morgen und schreibt einen Kurzbericht. Eine Wochenzusammenfassung listet auf, was sich geändert hat.
Vor Freigabe prüfen
Ihr Team erhält die vorgeschlagene Änderung, die Testnachweise und jeden geplanten Kurzbericht. Die Veröffentlichung wird separat entschieden.
- Läuft auf
- Kommandozeile, IDE, Desktop-App oder die Cloud von OpenAI. Team Tasks laufen in der Cloud über ein Dienstkonto.
- Verbindet sich mit
- Ihr Repository, Skripte, CI und MCP-Werkzeuge. Automations starten nach Zeitplan oder bei unterstützten App-Ereignissen.
- Eine Person gibt frei
- Eine Person prüft Änderungen, Testergebnisse und das Ergebnis jedes geplanten Laufs.
- Grenze
- Bezahlter ChatGPT-Tarif oder API-Schlüssel. Eine lokale Automation braucht die geöffnete App. Netzwerk ist in der Sandbox standardmäßig aus.
n8n
Ein Workflow-Werkzeug, das Ihre Apps verbindet und Daten zwischen ihnen bewegt.
Anfragen zum richtigen nächsten Schritt bringen.
Formular, Datensätze und Antwortentwurf verbinden. Fehlende Angaben gehen an eine Person, statt verloren zu gehen.
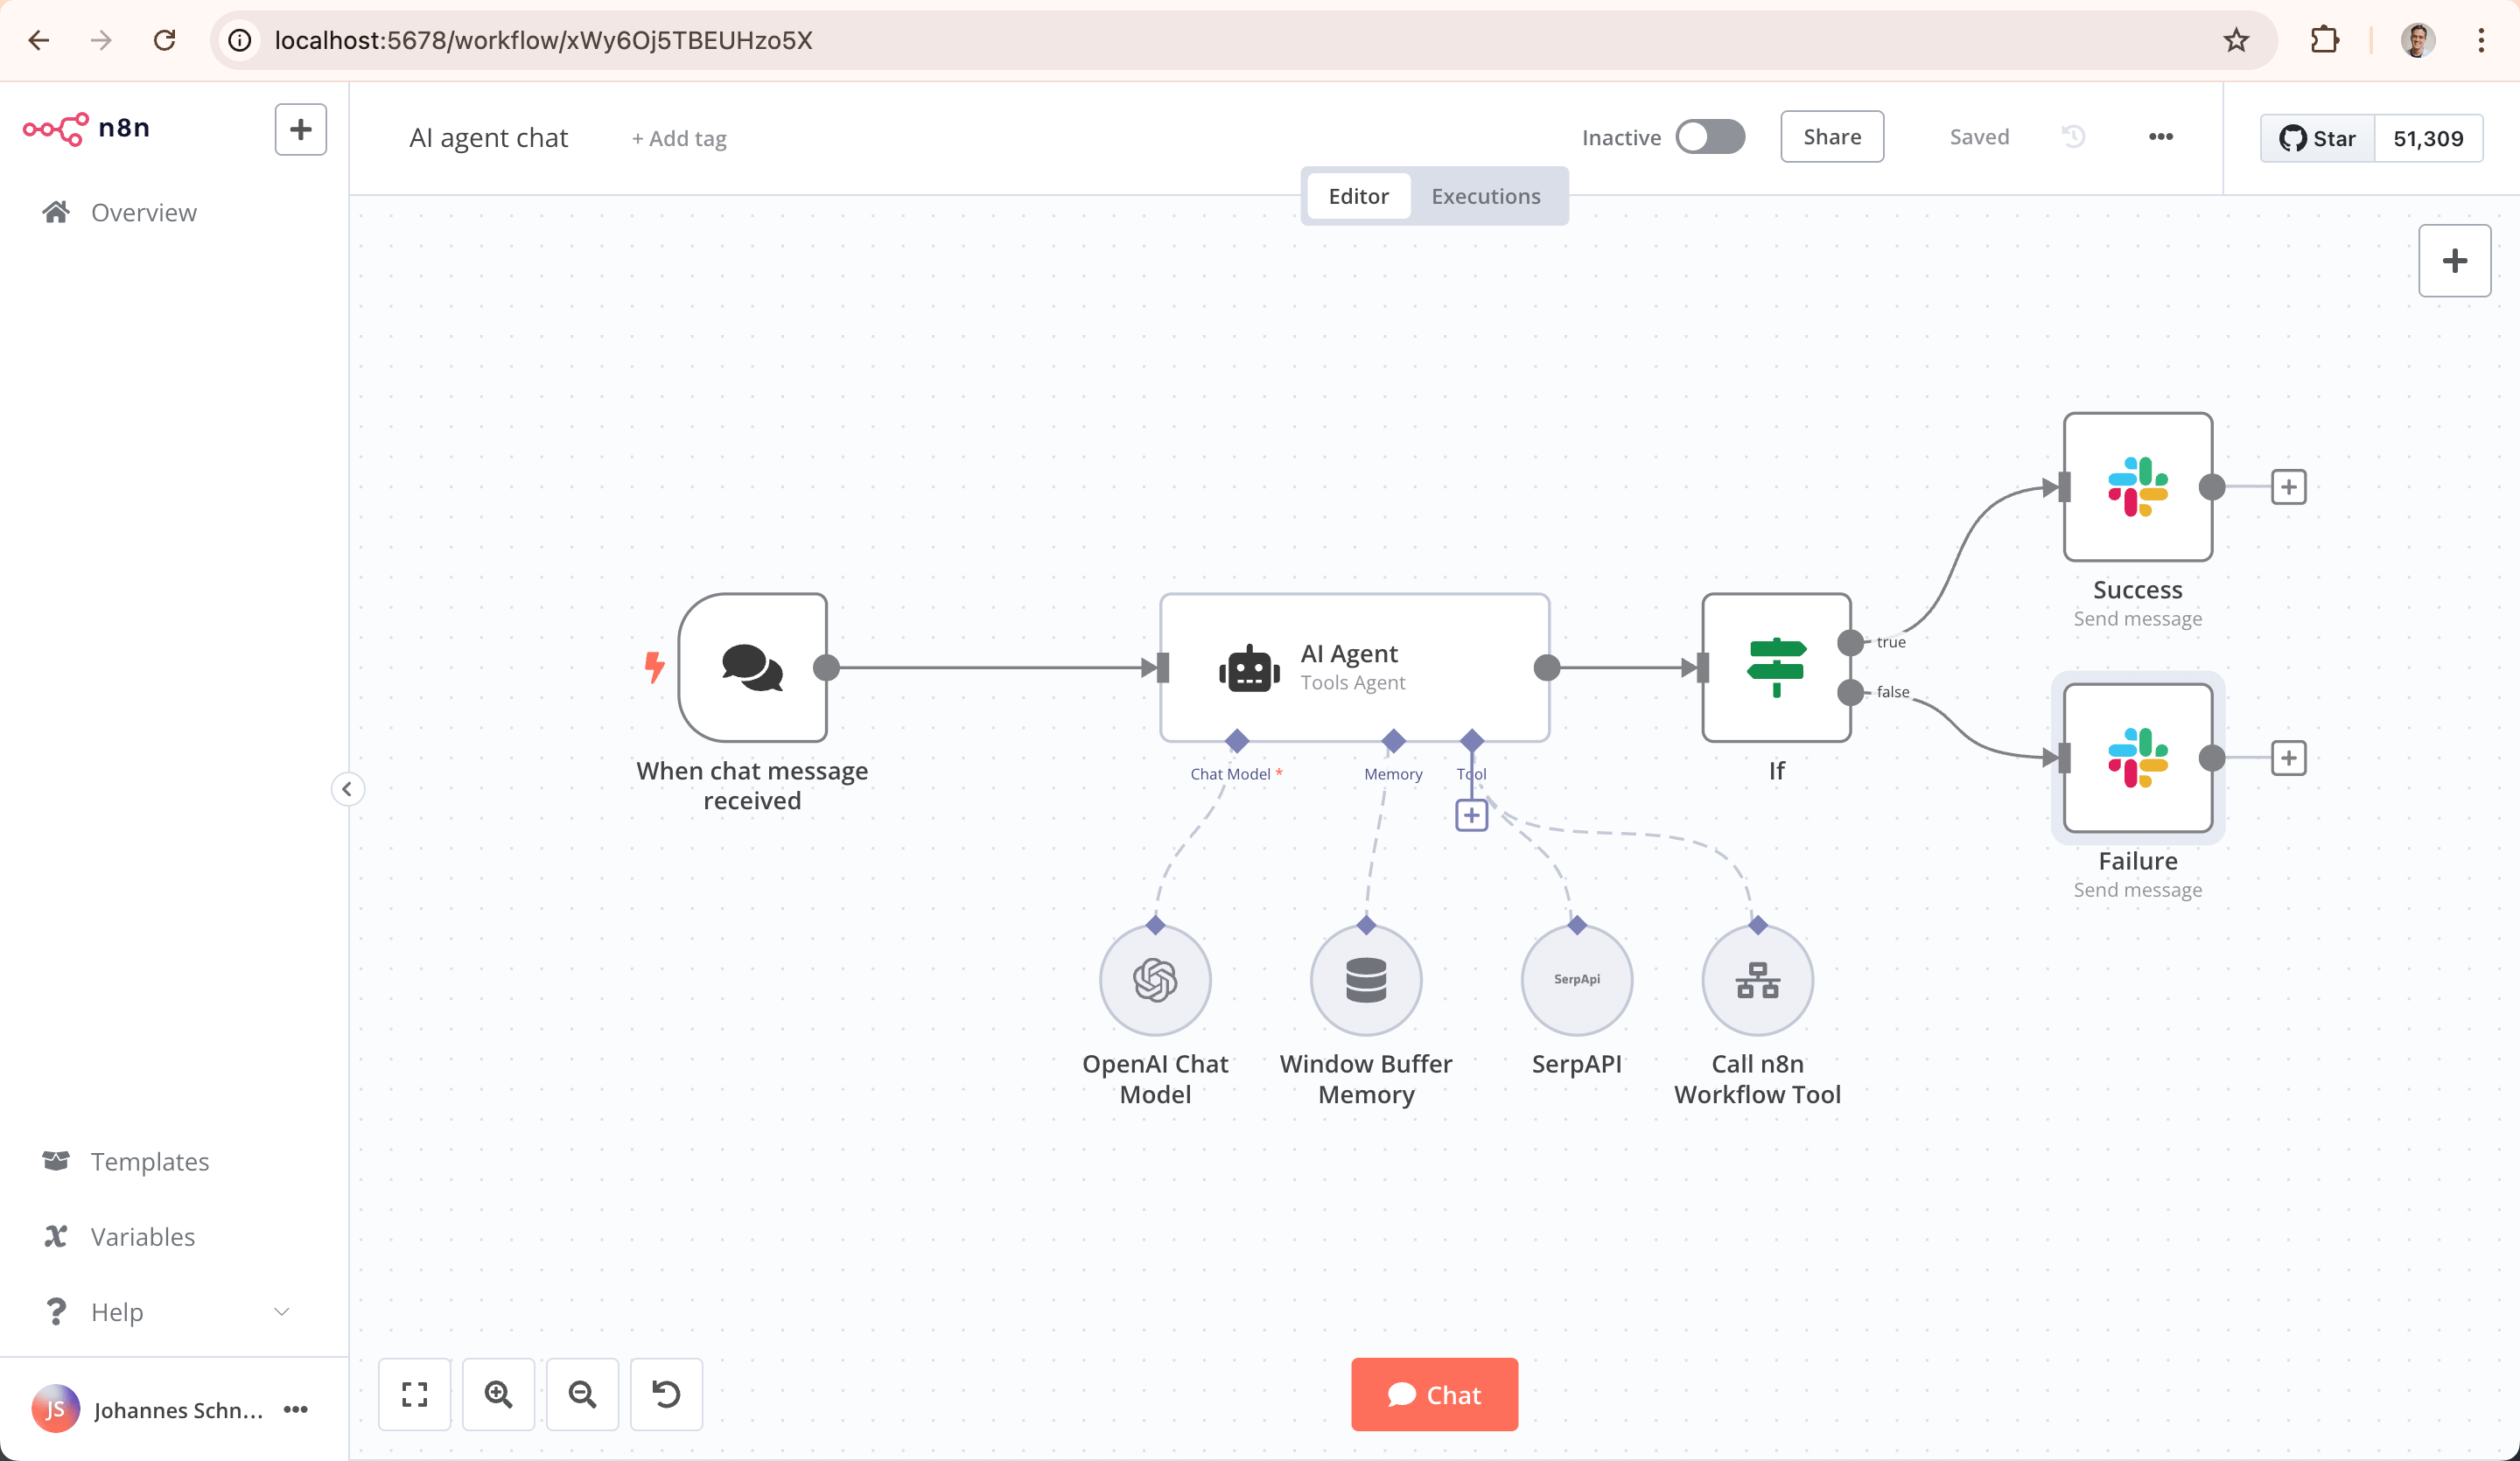 Referenzbild vergrößern
Beispielablauf · Beispieldaten
Anfrage erhalten
Ein Kunde fragt über Ihr bestehendes Formular ein Angebot an.
Angaben prüfen
Pflichtfelder prüfen und kontrollieren, ob die Anfrage bereits vorliegt.
Arbeit zuordnen
Datensatz erstellen oder aktualisieren und die nächste Aufgabe dem passenden Team zuordnen.
Antwort prüfen
Ein Antwortentwurf wartet auf Freigabe. Unvollständige Anfragen bleiben in einer Übergabeliste sichtbar.
- Läuft auf
- Ihr Server (etwa mit Docker) oder die n8n-Cloud.
- Verbindet sich mit
- Hunderte Geschäftsanwendungen, Webhooks, Formulare und KI-Modelle.
- Eine Person gibt frei
- Der Ablauf kann pausieren, bis eine Person freigibt.
- Grenze
- Lizenz für interne Geschäftsnutzung. Warnungen nur, wenn eingerichtet.
Open Harness
AuraMinds eigener Arbeitsbereich, in dem mehrere KI-Werkzeuge an einer Aufgabe arbeiten.
Diskussion und Umsetzung zusammenhalten.
AuraMinds funktionsfähiger Prototyp hält Modelldiskussionen, einen freigegebenen Plan und Tests in einem Arbeitsbereich.
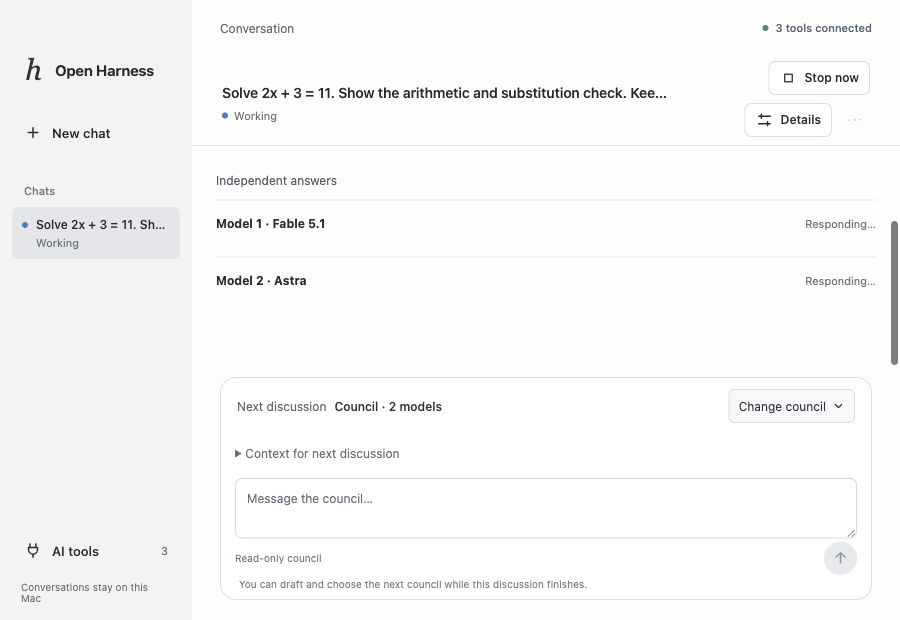 Referenzbild vergrößern
Beispielablauf · Beispieldaten
Eine Frage mitbringen
Ansätze vergleichen, bevor unser Projekt geändert wird.
Perspektiven vergleichen
Ausgewählte Modelle antworten unabhängig und prüfen einen gemeinsamen Vorschlag.
Freigeben und umsetzen
Ein abgestimmter Plan geht an ein geeignetes Programmierwerkzeug. Die Prüfung läuft separat.
Nachweise prüfen
Gespeicherte Diskussion, Änderungen und Prüfergebnisse vor der Abnahme durchsehen.
- Läuft auf
- Ihr Mac, als Desktop-Prototyp.
- Verbindet sich mit
- Claude Code und Codex, mit eigener Anmeldung.
- Eine Person gibt frei
- Sie geben den Plan frei und prüfen dann das Ergebnis.
- Grenze
- Funktionierender Prototyp. Ausweichen nur auf dasselbe Modell.
Beispiele zeigen eine mögliche Einrichtung. Konten, Berechtigungen und Freigaben werden für Ihr Unternehmen eingerichtet. Alle Werkzeuge und Integrationen ansehen
Hier entwickelt.
Bereit zum Entdecken.
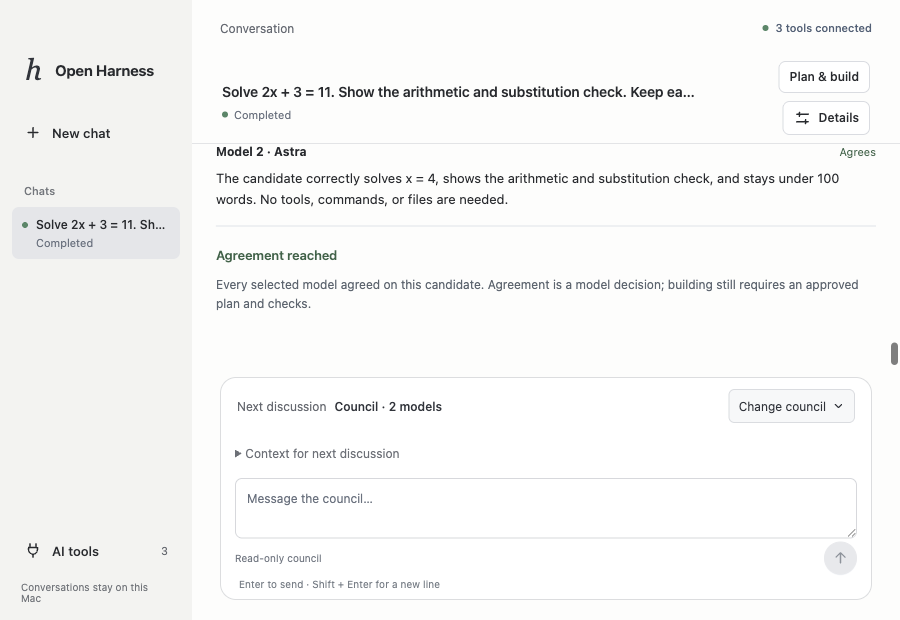 Echter Bildschirm des Prototyps
Funktionsfähiger Prototyp
Open Harness
Modelle vergleichen Ideen. Planung, Umsetzung und Prüfungen bleiben in einem Arbeitsbereich.
Arbeitsbereich ansehenSprechen. Aufnehmen. Prüfen.
⌥PI
In Entwicklung
Local Dictation
Mit Stimme und Screenshots erklären. Die Nachricht prüfen, bevor Sie sie absenden.
Prototyp entdecken2 · Ihre eigene KI
Lokale KI-Modelle
auf Ihrer eigenen Unternehmensinfrastruktur betreiben.
Ein offenes KI-Modell läuft auf einem Server oder Mac in Ihrem Unternehmen. Wir verbinden es mit Ihren Dokumenten und Werkzeugen, und Ihr Team stellt ihm Fragen wie einem Chat-Assistenten. Wo es sich lohnt, trainieren wir es auf Ihr Unternehmen. Mit ausgeschalteten Cloud-Funktionen verlässt nichts Ihr Netzwerk.
FirmenassistentInterne Anwendung · nutzt Ihr eigenes Modell
Aus dem Team · FirmenassistentWelche Garantie geben wir auf Bremsbeläge?
Ihr lokales Modell · gemma4:31b24 Monate oder 40.000 km, je nachdem, was zuerst eintritt.
Quelle: Servicehandbuch, Seite 12
Anfrage über die Website · n8n-WorkflowKönnen Sie unsere zwei Transporter am Samstag warten?
Ihr lokales Modell · gemma4:31bJa. Am Samstag sind zwei Termine frei, 9:00 und 11:00 Uhr. Antwortentwurf liegt bereit und wartet auf Ihre Freigabe.
Quelle: Öffnungszeiten und Preisliste 2026
Lieferantenrechnung · n8n-WorkflowRechnung 4471 mit der Bestellung abgleichen.
Ihr lokales Modell · gemma4:31bBetrag und Mehrwertsteuer stimmen mit der Bestellung überein. Das Lieferdatum weicht um einen Tag ab, deshalb geht sie an eine Person.
Quelle: Bestellung 4471 und das Rechnungs-PDF
Firmenserver · Ollama
$ ollama ps
NAME          ID              SIZE     PROCESSOR    CONTEXT    UNTIL
gemma4:31b    3f1e9c27a0b4    21 GB    100% GPU     32768      Forever

$ ollama serve
Listening on 10.0.4.10:11434 (version 0.12)
[GIN] 2026/10/12 - 09:14:03 | 200 | 1.9s | 10.0.4.21 | POST "/v1/chat/completions"- Modell
- gemma4:31b · 4-Bit
- Hardware
- Eine Workstation-GPU mit 32 GB
- Adresse für Ihre Werkzeuge
http://ai.internal:11434/v1- Cloud-Funktionen
- Aus
- Daten, die Ihr Netz verlassen
- Keine
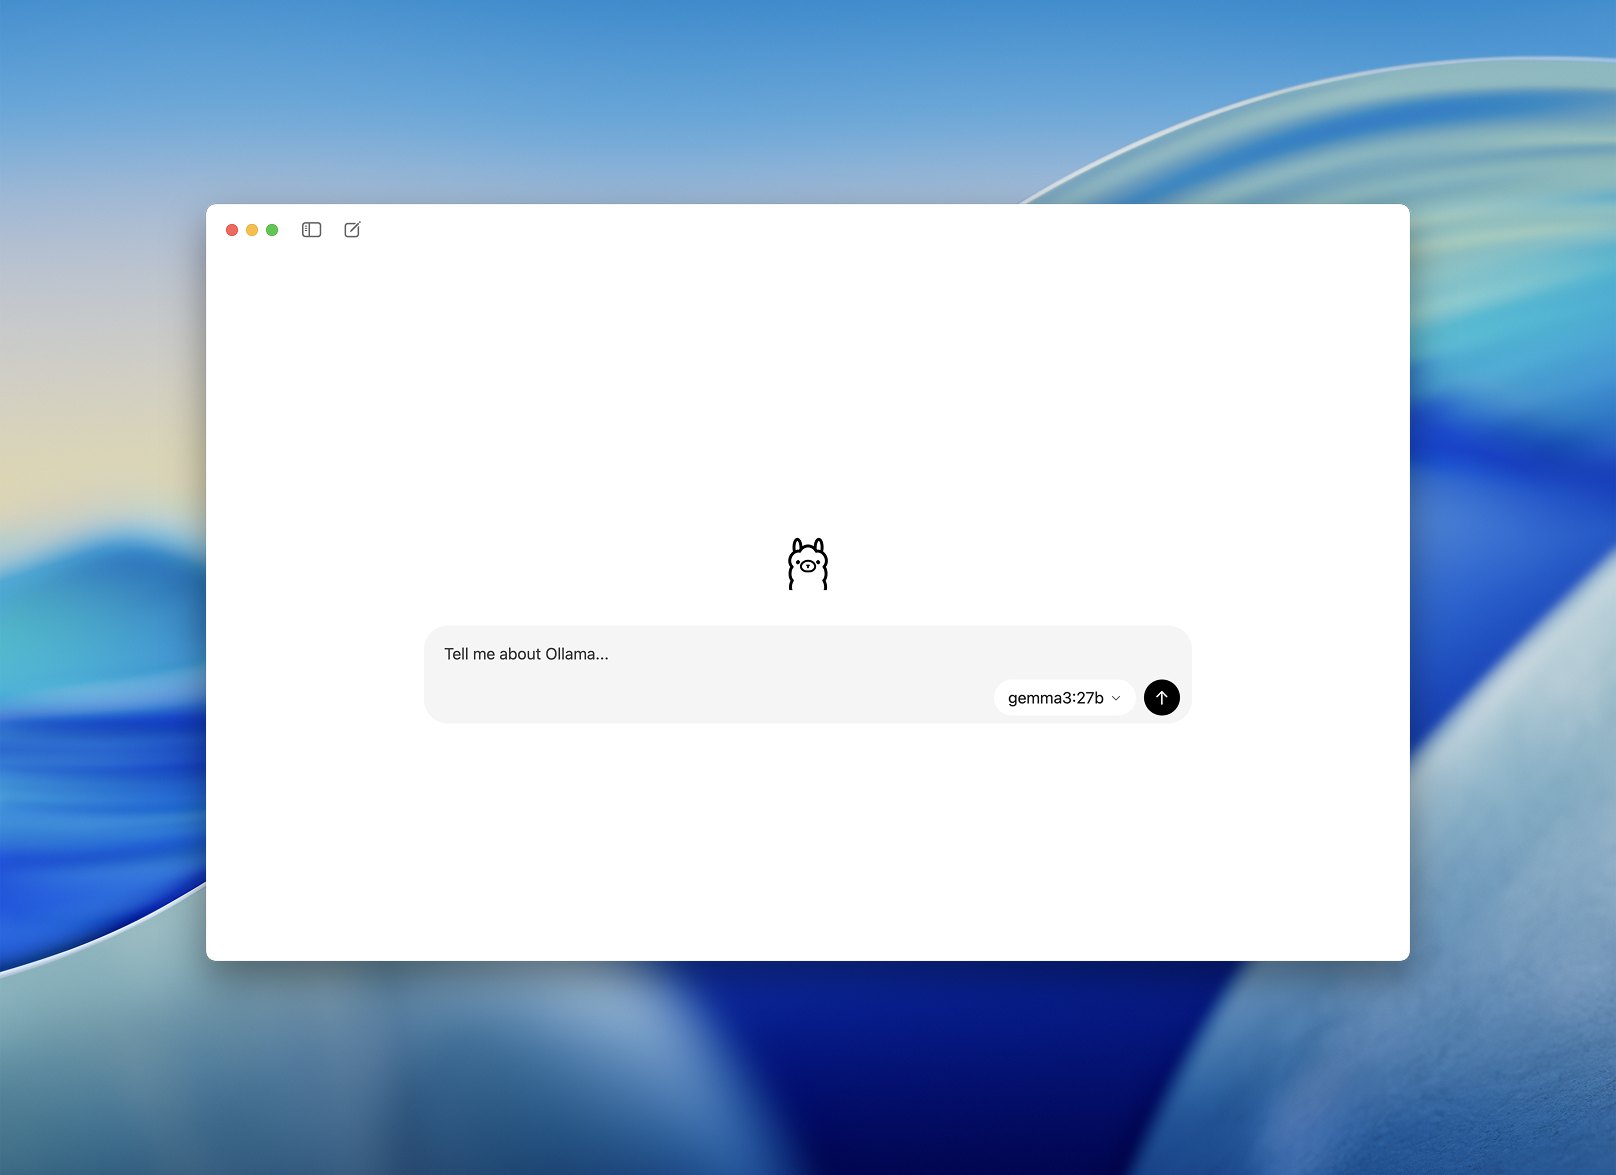
Was ist Ollama?
Ollama ist kostenlose Open-Source-Software, die ein offenes KI-Modell auf Ihrem eigenen Mac, PC oder Server ausführt. Ihre Apps sprechen mit ihm genauso wie mit OpenAI, sodass nichts neu gebaut werden muss. Mit ausgeschalteten Cloud-Funktionen bleiben Fragen und Antworten auf Ihrem Rechner.
Wenn viele Personen es gleichzeitig nutzen, laufen dieselben Modelle auf vLLM oder SGLang auf einem Linux-Server mit NVIDIA-GPUs. Wir wählen die Laufzeitumgebung für Ihre Last.
Bild: die offizielle Ollama-App, ollama.com. Keine Partnerschaft.
Die offenen Modelle, die wir für Unternehmen betreiben.
Alle lassen sich mit einem Befehl über Ollama herunterladen und laufen ohne Internetverbindung. Wir testen zwei oder drei an Ihrer echten Aufgabe und behalten das Modell, das am besten antwortet.
- Gemma 4Google DeepMind · Apache 2.0Dokumente und Antworten mit Quelle; eine gute erste Wahl für deutschsprachige Teams.Läuft auf 12B auf einem Rechner mit 16 GB. 31B auf einer GPU mit 24 bis 32 GB.
- Qwen 3.5 · 3.6 · 3.8Alibaba · Apache 2.0Agenten, die Werkzeuge nutzen, Hilfe beim Programmieren und mehrstufige Aufgaben.Läuft auf 9B mit 16 GB. 27B auf einer Workstation-GPU. 122B braucht 48 bis 96 GB.
- gpt-ossOpenAI · Apache 2.0Werkzeugnutzung, Antworten in festem Format und kurze Denkschritte.Läuft auf 20B innerhalb von 16 GB. 120B auf einer GPU mit 80 GB.
- DeepSeek-R1DeepSeek · MITSchrittweise Prüfungen, bei denen die Begründung sichtbar sein soll.Läuft auf Destillierte 7B bis 70B auf Workstations. 671B auf einem Server mit mehreren GPUs.
- Llama 3.1Meta · Llama-Community-LizenzEine weit verbreitete Basis für Entwürfe und Zusammenfassungen.Läuft auf 8B mit 16 GB. 70B braucht 40 bis 48 GB.
Größen und Speicherbedarf sind Näherungswerte und hängen von Quantisierung und Kontextlänge ab. Abgeglichen mit den offiziellen Modellkarten und der Ollama-Bibliothek am 11. Oktober 2026.
Warum es für ein ganzes Unternehmen funktioniert.
- Ein Server, viele Teams
Service, Vertrieb und Buchhaltung nutzen dasselbe Modell über eine interne Adresse. Für viele Menschen gleichzeitig läuft es mit vLLM oder SGLang auf einem GPU-Server.
- Ihre Daten bleiben im Haus
Dokumente, Fragen und Antworten bleiben auf Ihrer Hardware. Wer das Modell nutzen darf und was protokolliert wird, wird eingerichtet und dokumentiert.
- Feste Kosten, keine Gebühren pro Anfrage
Sie zahlen für die Hardware und ihren Betrieb, nicht für jede Frage. Wir vergleichen das vor Ihrer Entscheidung mit den Kosten einer Cloud-API für Ihr Volumen.
- Ihre Werkzeuge bleiben gleich
n8n, OpenClaw, Hermes Agent und Ihre eigenen Anwendungen rufen die interne Adresse statt einer Cloud-API auf. Nur die Adresse ändert sich.
Eine normale Woche
mit AuraMind.
Vier Alltagssituationen aus dem Film. Beispielhafte Abläufe: Eine Person gibt frei, bevor etwas veröffentlicht, gesendet oder bezahlt wird.
1 / 4 · Social Media
Ein Foto der Tarte von heute.
Ein kurzes Video und zwei Beiträge zur Freigabe.
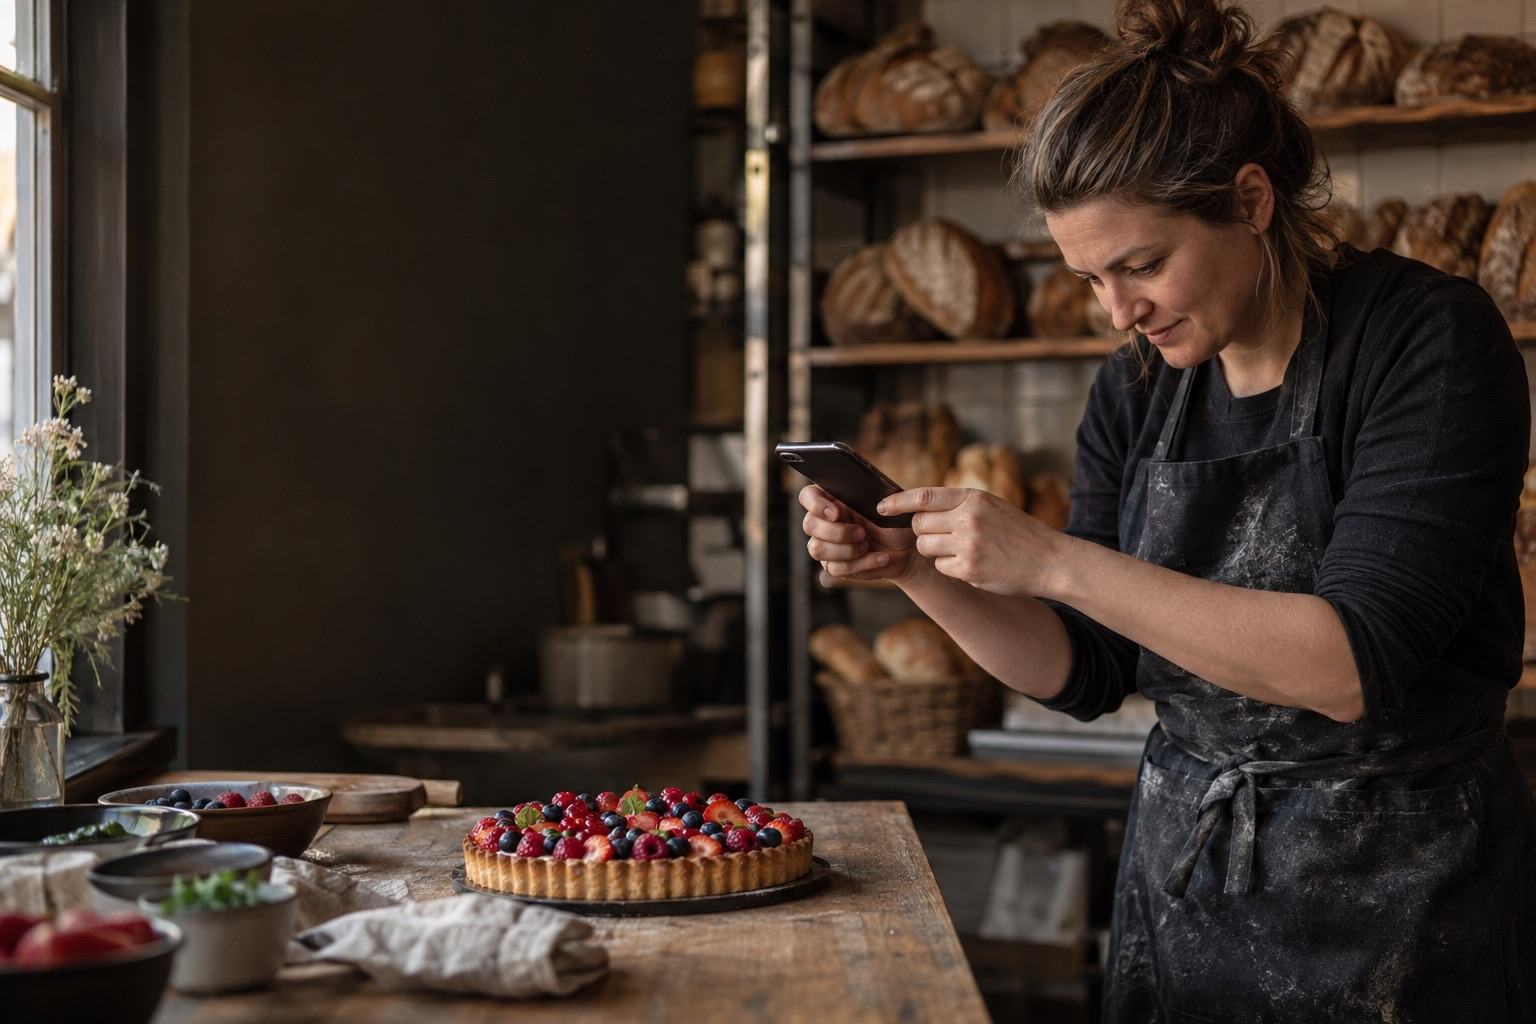
Die Bäckerei macht ein Foto mit dem Handy. Ihr eigenes Modell schreibt die Texte in Ihrem Ton, und ein Workflow bereitet ein kurzes Video, einen Instagram-Beitrag und einen Facebook-Beitrag vor. Veröffentlicht wird erst nach Ihrer Freigabe.
- Ein Foto vom Handy
- Ein kurzes Video und zwei Beiträge werden entworfen
- Sie geben frei, dann werden sie eingeplant
Ihr eigenes Modell · OpenClaw oder n8n · Ihr Planungstool
- Kurzes Video · 9 sQuadratischer Schnitt mit dem Foto und Ihrem LogoBereit zur Freigabe
- Instagram-BeitragText in Ihrem Ton, zwei HashtagsBereit zur Freigabe
- Facebook-BeitragDasselbe Foto, Öffnungszeiten ergänztBereit zur Freigabe
FreigebenBearbeiten
2 / 4 · Anfragen
Eine Anfrage um zehn Uhr abends.
Bis zum Morgen eine Antwort aus Ihrer Preisliste.
Die Anfrage landet um 22:04 Uhr in Ihrem Postfach. Über Nacht liest Ihr eigenes Modell sie, prüft Ihre Preisliste 2026 und entwirft die Antwort. Am Morgen wartet der Entwurf auf Ihr OK. Ohne Ihr OK wird nichts gesendet.
- Die Anfrage kommt um 22:04 Uhr an
- Eine Antwort wird aus Ihrer Preisliste entworfen
- Sie wartet auf Ihr OK, dann wird sie gesendet
Ihr eigenes Modell · n8n · Ihr Postfach und CRM
Können Sie ab März unsere zwei Gebäude verwalten?
Guten Morgen. Ja, wir können beide Gebäude ab dem 1. März übernehmen. Den Satz aus unserer Preisliste 2026 und die nächsten Schritte finden Sie unten.
Quelle: Preisliste 2026Wartet auf Ihr OK
SendenBearbeiten
3 / 4 · Rechnungen
Eine Lieferantenrechnung wird gelesen,
mit der Bestellung abgeglichen und gebucht.
Die Rechnung kommt als PDF an. Die Felder werden gelesen, die Summe wird mit der Bestellung abgeglichen und die Buchung in Ihrer Buchhaltung vorbereitet. Unklare Werte werden für eine Person markiert. Die Zahlung bleibt bei Ihrem Team.
- Die Rechnung kommt als PDF an
- Felder werden gelesen und mit der Bestellung abgeglichen
- Gebucht; Ihr Team gibt die Zahlung frei
Dokumentenparser · Ihr eigenes Modell · n8n · Ihre Buchhaltung
- Lieferant
- Bremsenteile-Lieferant
- Rechnungsnr.
- 2026-0917
- Datum
- 3. Oktober 2026
- Netto
- 1.240,00 EUR
- MwSt. 19 %
- 235,60 EUR
- Gesamt
- 1.475,60 EUR
Passt zu Auftrag #4471GebuchtZahlung: Ihr Team
4 / 4 · Antworten im Team
Ein neuer Kollege fragt nach der Garantie.
Die Antwort kommt aus Ihrem Servicehandbuch.
Die Frage geht in den Team-Chat. Ihr eigenes Modell antwortet aus dem Servicehandbuch und nennt die Seite, damit der Kollege es prüfen kann. Die Wissensbasis ist gemeinsam, so bleibt jede Antwort für das ganze Team verfügbar.
- Eine Frage im Team-Chat
- Die Antwort kommt aus dem Servicehandbuch, mit Seitenangabe
- Eine gemeinsame Wissensbasis für alle
Ihr eigenes Modell · gemeinsame Wissensbasis · Ihr Team-Chat
Wie lange ist unsere Garantie auf Bremsbeläge?
24 Monate oder 40.000 km.
Servicehandbuch, Seite 12
Technologie passend zur AufgabeDen Stack erkunden
Arbeit, die Sie
nachvollziehen können.
Alle Projekte ansehen
Kundenprojekt · Voice
Sprachassistenz für Werkstätten
ProblemEine Werkstatt wollte Anrufe auf Französisch annehmen und Fahrzeug, Kontaktdaten und Terminwunsch erfassen.
ErgebnisEin konfigurierter Empfangsassistent mit Anweisungen zur Aufnahme von Terminanfragen.
Kundenprojekt · Lokale KI
Lokale Agenten auf einem Mac mini
ProblemDer Kunde wollte Agenten auf dem eigenen Mac mini betreiben und wissen, was 16 GB Arbeitsspeicher leisten.
ErgebnisEin geprüftes Setup, ein Installationsskript und eine praktische Betriebsanleitung.
Eigene Entwicklung · Recherche
Recherche mit nachvollziehbaren Quellen
ProblemRechercheentwürfe brauchten Quellen, die eine Person vor dem Speichern prüfen kann.
ErgebnisRecherche mit Quellenbelegen und deutsche Entwürfe zur Prüfung.
Beschreiben Sie die Aufgabe.
Wir planen den nächsten Schritt.
Wir planen es mit Ihnen, bauen es und halten es am Laufen. Ein verpasster Anruf, eine wiederkehrende Aufgabe oder ein Modell auf Ihrem eigenen Server: Beginnen Sie mit einer kurzen Nachricht.
Muss ich mich mit KI auskennen?
Nein. Erzählen Sie uns, was Zeit kostet. Wir erklären die Möglichkeiten und helfen Ihnen, einen sinnvollen ersten Ablauf auszuwählen.
Können Sie meine vorhandenen Tools anbinden?
Wir prüfen zunächst Telefon, Kalender, CRM und Ihre weiteren Systeme. Die Einrichtung hängt von deren Schnittstellen und Zugriffsmöglichkeiten ab.
Was kostet die Einrichtung?
Wir legen den Umfang gemeinsam fest und erläutern die Kosten für Einrichtung und Betrieb, bevor Sie sich entscheiden.