Wir richten ein Sprachmodell auf Ihrem eigenen Server ein und trainieren es auf Ihr Unternehmen: Ihre Produkte, Ihre Preise, Ihre Arbeitsweise. Ihre Daten bleiben in Ihrem Unternehmen. Es gibt keine Gebühren pro Anfrage, und Sie sind nicht von der Cloud eines anderen abhängig.
Ein lokales Modell bei der Arbeit.
Ihr Team fragt den Firmenassistenten. Die Antwort kommt vom Modell auf Ihrem eigenen Server, und das Serverprotokoll zeigt, dass jede Anfrage im Unternehmen bleibt.
Illustration eines lokalen Modells bei der Arbeit · Beispieldaten
FirmenassistentInterne Anwendung · nutzt Ihr eigenes Modell
Aus dem Team · FirmenassistentWelche Garantie geben wir auf Bremsbeläge?
Ihr lokales Modell · gemma4:31b24 Monate oder 40.000 km, je nachdem, was zuerst eintritt.
Quelle: Servicehandbuch, Seite 12
Anfrage über die Website · n8n-WorkflowKönnen Sie unsere zwei Transporter am Samstag warten?
Ihr lokales Modell · gemma4:31bJa. Am Samstag sind zwei Termine frei, 9:00 und 11:00 Uhr. Antwortentwurf liegt bereit und wartet auf Ihre Freigabe.
Quelle: Öffnungszeiten und Preisliste 2026
Lieferantenrechnung · n8n-WorkflowRechnung 4471 mit der Bestellung abgleichen.
Ihr lokales Modell · gemma4:31bBetrag und Mehrwertsteuer stimmen mit der Bestellung überein. Das Lieferdatum weicht um einen Tag ab, deshalb geht sie an eine Person.
Quelle: Bestellung 4471 und das Rechnungs-PDF
Fragen Sie nach einem Produkt, einem Auftrag oder einem Dokument↑
Firmenserver · Ollama
$ ollama ps
NAME          ID              SIZE     PROCESSOR    CONTEXT    UNTIL
gemma4:31b    3f1e9c27a0b4    21 GB    100% GPU     32768      Forever

$ ollama serve
Listening on 10.0.4.10:11434 (version 0.12)
[GIN] 2026/10/12 - 09:14:03 | 200 |   1.9s | 10.0.4.21 | POST "/v1/chat/completions"
Modell
gemma4:31b · 4-Bit
Hardware
Eine Workstation-GPU mit 32 GB
Adresse für Ihre Werkzeuge
http://ai.internal:11434/v1
Cloud-Funktionen
Aus
Daten, die Ihr Netz verlassen
Keine
Jede Anfrage kommt von einer Adresse im Unternehmen (10.0.x.x) und wird vom Modell auf Ihrem eigenen Server beantwortet. Zeiten und Namen sind Beispieldaten.
Was ist Ollama?
Ollama ist kostenlose Open-Source-Software, die ein offenes KI-Modell auf Ihrem eigenen Mac, PC oder Server ausführt. Ihre Apps sprechen mit ihm genauso wie mit OpenAI, sodass nichts neu gebaut werden muss. Mit ausgeschalteten Cloud-Funktionen bleiben Fragen und Antworten auf Ihrem Rechner.
Wenn viele Personen es gleichzeitig nutzen, laufen dieselben Modelle auf vLLM oder SGLang auf einem Linux-Server mit NVIDIA-GPUs. Wir wählen die Laufzeitumgebung für Ihre Last.
Bild: die offizielle Ollama-App, ollama.com. Keine Partnerschaft.
Mit einer vertrauten Aufgabe beginnen.
Diese Beispiele zeigen mögliche Einrichtungen. Modelltraining wird für Ihr Unternehmen vereinbart und ist keine Behauptung über eine abgeschlossene Kundenbereitstellung.
Verbindet freigegebene Eingaben, Validierung und nächste Aktionen.
Wo es läuft und wohin Daten fließen
Die vorgeschlagene lokale Einrichtung führt Modell und gewählten Wissensspeicher auf Ihrer Workstation oder Ihrem Firmenserver aus. Jede externe Verbindung wird separat aufgeführt.
Ihr Team behält die Kontrolle
Ihr Team bearbeitet und genehmigt die Ausgabe. Die Veröffentlichung ist eine getrennte Aktion mit eigener Berechtigung.
Wenn etwas schiefgeht
Fehlende Produktangaben werden zur Ergänzung markiert und nicht durch erfundene Spezifikationen ersetzt.
Wiederkehrender Dokumentenarbeit ein festes Ausgabeformat geben.
Das Modell schlägt strukturierte Felder vor. Anwendungsprüfungen markieren den Prüfbedarf.
Problem
Namen, Daten und Referenzen manuell kopieren und anschließend uneinheitliche Formate korrigieren.
Was eingeht
Unterstützte Dokumente und die im Ablauf benötigten Felder.
Was herauskommt
Ein strukturierter Datensatzentwurf mit sichtbaren fehlenden oder unsicheren Werten.
Der vollständige Ablauf, Schritt für Schritt
Der vollständige Ablauf
1Dokument einlesen
Text mit den vereinbarten lokalen Komponenten auslesen oder erkennen.
2Felder extrahieren
Das Modell um das festgelegte Ausgabeschema bitten.
3Validieren
Datentypen, Pflichtwerte und Referenzen prüfen.
4Ausnahmen prüfen
Unsichere Datensätze an die zuständige Person weiterleiten.
Verbindet freigegebene Eingaben, Validierung und nächste Aktionen.
Wo es läuft und wohin Daten fließen
Die vorgeschlagene lokale Einrichtung führt Modell und gewählten Wissensspeicher auf Ihrer Workstation oder Ihrem Firmenserver aus. Jede externe Verbindung wird separat aufgeführt.
Ihr Team behält die Kontrolle
Ihr Team klärt Ausnahmen, bevor Datensätze wichtige Folgeaktionen auslösen.
Wenn etwas schiefgeht
Ein unlesbares Dokument gelangt in eine Prüfliste. Ein gültiges JSON-Format allein belegt keine korrekten Werte.
Antworten in den eigenen Unternehmensinformationen finden.
Ein abgegrenzter Assistent ruft passende Inhalte ab und antwortet mit Quellenverweisen.
Problem
Geteilte Ordner durchsuchen und Kollegen nach dem aktuellen Leitfaden fragen.
Was eingeht
Freigegebene Richtlinien, Produktdokumente oder interne Leitfäden mit Zugriffsregeln.
Was herauskommt
Eine Antwort mit Bezug zum Quellenmaterial oder eine klare Bitte um Unterstützung.
Der vollständige Ablauf, Schritt für Schritt
Der vollständige Ablauf
1Dokumente indexieren
Dokumente organisieren und Zugriffsgrenzen beibehalten.
2Kontext abrufen
Zur berechtigten Nutzerfrage passende Inhalte finden.
3Antwort vorbereiten
Das lokale Modell mit dem abgerufenen Kontext verwenden.
4Quelle prüfen
Die zitierte Quelle vor einer Handlung prüfbar machen.
Verbindet freigegebene Eingaben, Validierung und nächste Aktionen.
Wo es läuft und wohin Daten fließen
Die vorgeschlagene lokale Einrichtung führt Modell und gewählten Wissensspeicher auf Ihrer Workstation oder Ihrem Firmenserver aus. Jede externe Verbindung wird separat aufgeführt.
Ihr Team behält die Kontrolle
Dokumentverantwortliche halten die Quellen aktuell. Nutzer können den unterstützenden Verweis prüfen.
Wenn etwas schiefgeht
Wenn die Quelle keine Antwort trägt, soll der Assistent dies benennen und die Frage weiterleiten.
Welche Modelle, auf welcher Hardware.
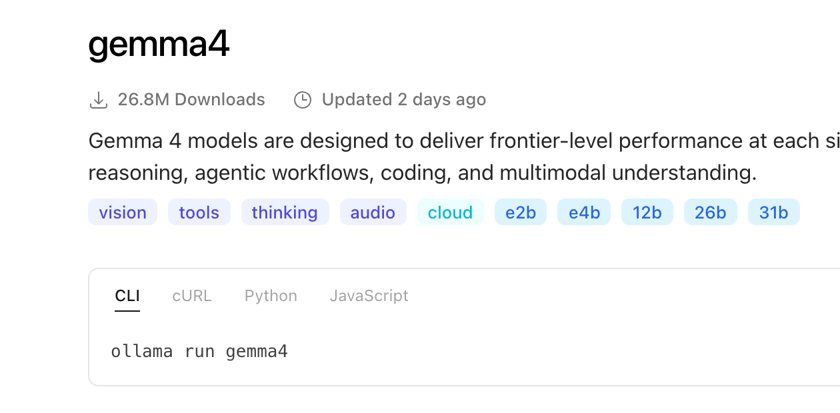
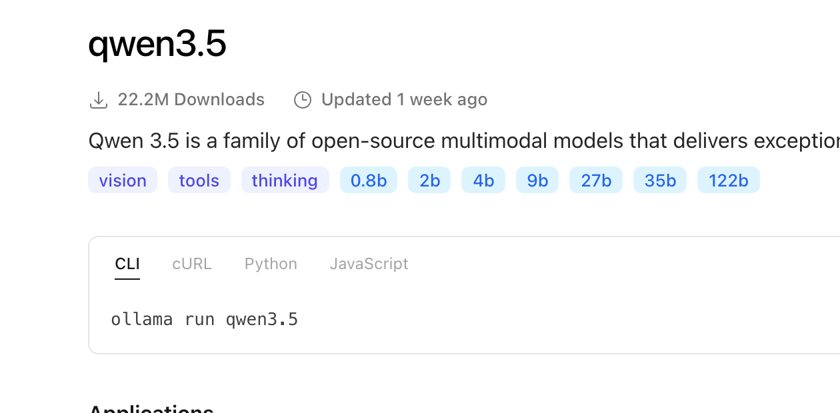
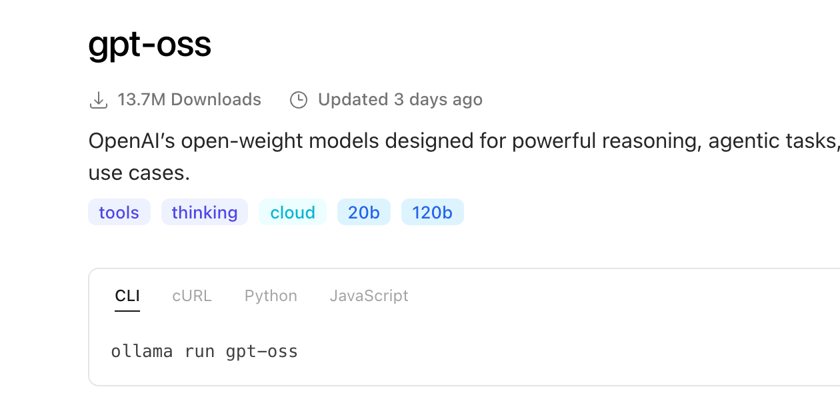
Modelle mit offenen Gewichten, die Sie selbst herunterladen und betreiben können. Diese Familien testen wir zuerst. Die Angaben stammen aus den offiziellen Modellkarten und der Ollama-Bibliothek, geprüft am 11. Oktober 2026.
Gemma 4
Google DeepMind
E2B
E4B
12B
26B A4B
31B
Lizenz
Apache 2.0
Kontext
128K bei E2B und E4B, 256K bei 12B, 26B A4B und 31B
Merkmale
Text- und Bildeingabe, Audio bei E2B, E4B und 12B. Über 140 Sprachen. Die kleinen Größen sind für Laptops gemacht, die großen für Consumer-GPUs und Workstations.
Geeignet für
Entwürfe, Dokumentenfelder und Antworten aus Firmendokumenten mit Quelle. Ein guter erster Kandidat für ein deutschsprachiges Team.
Läuft auf
12B in etwa 16 GB. 31B in 4-Bit auf einer Workstation-GPU mit 24 bis 32 GB.
Qwen3.5 · 3.6 · 3.8
Alibaba
9B
27B
35B-A3B
122B-A10B
Lizenz
Apache 2.0
Kontext
262.144 Token bei den 27B-Modellen von 3.5 und 3.8, erweiterbar auf etwa 1M
Merkmale
Bildeingabe und 201 Sprachen bei 3.5, agentisches Programmieren bei 3.6, Denkmodus bei 3.8. 35B und 122B sind Mixture-of-Experts-Modelle.
Geeignet für
Programmierhilfe, Agenten mit Werkzeugen und mehrstufige Aufgaben, bei denen das Modell vor der Antwort nachdenken soll.
Läuft auf
9B in etwa 16 GB. 27B und 35B-A3B in 4-Bit auf einer Workstation-GPU. 122B-A10B braucht 48 bis 96 GB.
gpt-oss
OpenAI
20B
120B
Lizenz
Apache 2.0
Kontext
128K (Ollama-Eintrag, die Modellkarte nennt keine Zahl)
Merkmale
Denkaufwand niedrig, mittel oder hoch, Funktionsaufrufe und strukturierte Ausgaben. 20B hat 3,6B aktive Parameter, 120B hat 5,1B.
Geeignet für
Agenten mit Werkzeugen und Prüfungen, Dokumentenfelder in festem Format und Aufgaben mit kurzem Denkschritt.
Läuft auf
20B in 16 GB Speicher. 120B auf einer 80-GB-GPU.
Bekannte Alternativen mit ihren Lizenzhinweisen
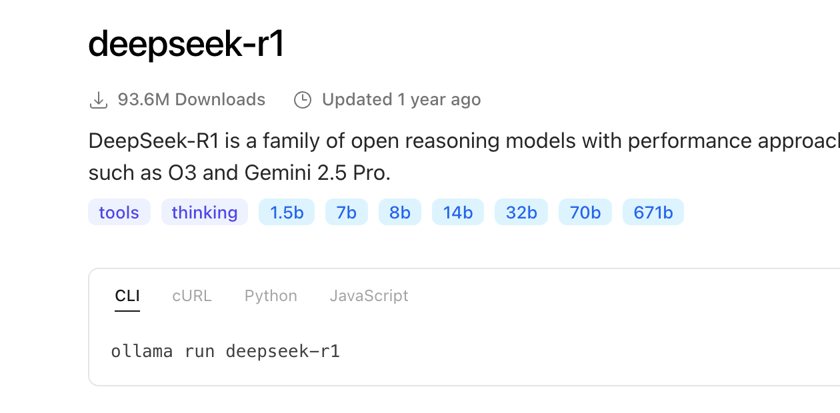
DeepSeek-R1
DeepSeek
1.5B to 70B
671B
Lizenz
MIT
Kontext
128K
Merkmale
Offenes Reasoning-Modell, 671B gesamt mit 37B aktiv. Die kleinen Größen sind destillierte Qwen- und Llama-Modelle.
Geeignet für
Schrittweise Prüfungen und Vergleiche, bei denen der Denkweg sichtbar sein soll.
Läuft auf
Die destillierten Größen passen in die ersten Stufen. Das 671B-Modell braucht einen Multi-GPU-Server.
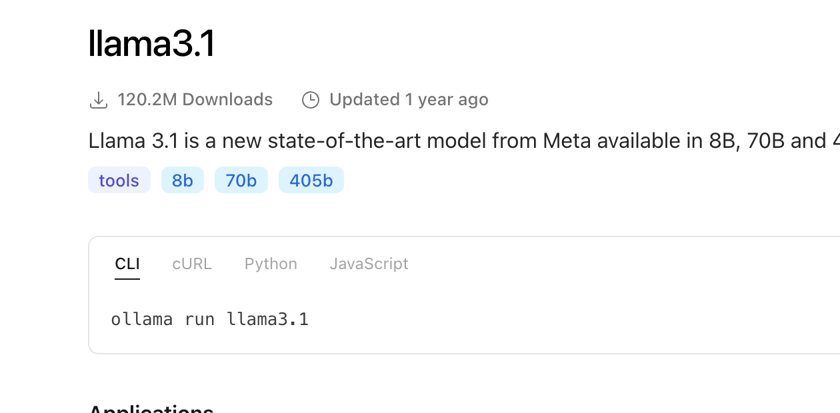
Llama 3.1
Meta
8B
70B
405B
Lizenz
Llama-Community-Lizenz, vor gewerblicher Nutzung lesen
Kontext
128K
Merkmale
Text rein, Text raus. Zu den unterstützten Sprachen gehören Englisch und Deutsch.
Geeignet für
Eine weit verbreitete Basis für Entwürfe und Zusammenfassungen.
Läuft auf
8B in etwa 16 GB bei 4-Bit. 70B in 4-Bit braucht etwa 40 bis 48 GB. 405B ist ein Multi-GPU-Server-Modell.
Die Größen sind die Tags der Ollama-Bibliothek. A3B, A4B und A10B nennen die aktiven Parameter eines Mixture-of-Experts-Modells. Der Speicherbedarf hängt von Quantisierung, Kontextlänge und Laufzeitumgebung ab, deshalb ist jede Zahl hier ein Näherungswert. Deutschqualität, Lizenz und Werkzeugunterstützung werden pro Projekt getestet, und die Übergabe nennt den gemessenen Wert.
Vier Hardwarestufen, bei 4-Bit.
Was ein Unternehmen schon besitzt oder kaufen kann, und welche Modelle darauf passen. Eine GPU oder ein Mac mit genug Speicher ist meist schon der ganze Server.
Etwa 16 GBLaptop oder kleiner Desktop
Ein Mac mini mit 16 GB, ein Laptop oder eine Grafikkarte mit 16 GB.
Passt bei 4-Bit
gpt-oss 20B
Gemma 4 12B
Qwen3.5 9B
Llama 3.1 8B
7B bis 14B in 4-Bit
Geeignet für
Ein erster Test oder eine kleine Arbeitslast für ein Team.
GPU mit 24 bis 32 GBoder ein Mac mit 32 bis 64 GB
Eine Workstation mit einer RTX 4090 oder 5090 oder ein Mac mit 32 bis 64 GB gemeinsamem Speicher.
Passt bei 4-Bit
Qwen3.6 oder 3.8 27B, etwa 16 GB
Gemma 4 31B
Qwen3.5 35B-A3B, etwa 22 GB
Geeignet für
Der übliche Firmenserver für ein kleines Team: die Klasse von 27B bis 35B.
48 bis 96 GBZwei GPUs, eine 80-GB-GPU oder ein Mac Studio
Zwei Workstation-GPUs, ein Server mit einer 80-GB-GPU oder ein Mac Studio mit 96 bis 192 GB gemeinsamem Speicher.
Passt bei 4-Bit
gpt-oss 120B, 80 GB
Qwen3.5 122B-A10B, etwa 70 GB
70B dicht in 4-Bit, 40 bis 48 GB
Geeignet für
Größere Modelle oder mehrere Teams gleichzeitig am Server.
Multi-GPU-ServerMehrere Rechenzentrums-GPUs
Ein Rack-Server mit mehreren Rechenzentrums-GPUs.
Passt bei 4-Bit
DeepSeek-V4
Qwen3.8 2.4T
Llama 3.1 405B
Geeignet für
Die größten offenen Modelle. Für ein kleines Unternehmen selten sinnvoll.
Die Zahlen sind Näherungswerte: Quantisierung, Kontextlänge und Laufzeitumgebung verändern sie. Die Übergabe nennt den gemessenen Wert für Ihren Rechner.
So wird es eingerichtet.
Ein Endpunkt in Ihrem Netz, die bereits genutzten Werkzeuge daran angebunden, Cloud-Modi aus und ein Adapter nur dort, wo Tests ihn rechtfertigen.
01
Das Modell bereitstellen
Ollama oder vLLM betreiben das Modell hinter einem OpenAI-kompatiblen Endpunkt im Firmennetz. Ollama für einen Rechner, vLLM oder SGLang auf einem Linux-Server mit NVIDIA-GPUs, wenn viele gleichzeitig zugreifen.
OllamavLLMSGLang
02
Ihre Werkzeuge anbinden
n8n, OpenClaw, Hermes Agent und Ihre internen Anwendungen rufen diesen Endpunkt statt einer Cloud-API auf. Die Adresse ändert sich, die Abläufe bleiben.
n8nOpenClawHermes AgentInterne Apps
03
Die Cloud abschalten
Der Cloud-Modus der Laufzeitumgebung bleibt aus. Wer den Endpunkt erreichen darf, was protokolliert wird und wie Sicherungen laufen, wird eingerichtet und dokumentiert.
Cloud-ModusZugriffProtokolleSicherungen
04
Feinjustieren, wo es sich lohnt
Wo Tests es rechtfertigen, wird ein LoRA- oder QLoRA-Adapter auf einer eigenen oder gemieteten GPU trainiert und auf Ihren Server geladen. Fakten kommen weiterhin aus Ihren Dokumenten.
LoRAQLoRAHugging Face TRL und PEFT
Das Training kann auf einem anderen Rechner laufen als der tägliche Betrieb. Wo Trainingsdaten vorbereitet werden und wo der Job läuft, wird vor jeder Übertragung vereinbart.
Was es für Ihr Unternehmen tut.
Vier Alltagssituationen aus unserem Unternehmensfilm, als Illustration gezeigt. Jede läuft auf demselben lokalen Modell, und eine Person gibt frei, bevor etwas verschickt, veröffentlicht oder gebucht wird.
Welche Garantie geben wir auf Bremsbeläge?24 Monate oder 40.000 km.Antwort aus Ihren eigenen DokumentenServicehandbuch, S. 12
Antworten aus Ihren eigenen Handbüchern
Eine neue Kollegin fragt nach der Garantie und bekommt die Antwort aus Ihrem Servicehandbuch, mit der Seite, aus der sie stammt.
Quelle
Freigegebene Handbücher und Richtlinien
Eine Person
Prüft die genannte Seite, bevor sie danach handelt
RechnungAuftragPasst zu Auftrag #4471Lieferant, Betrag, Datum, MwSt. ausgefülltBereit für Ihre Buchhaltung
Rechnungsfelder, gegen den Auftrag geprüft
Eine Lieferantenrechnung wird gelesen, ihre Felder werden mit Ihrem Auftrag verglichen, und der Datensatz wird für Ihre Buchhaltung vorbereitet.
Quelle
Die Rechnung und Ihre Auftragsdaten
Eine Person
Bestätigt Abweichungen, bevor etwas gebucht wird
22:04Können Sie ab März unsere zwei Gebäude verwalten?07:30Antwort aus Preisliste 2026 entworfenIn Ihrem Ton, aus freigegebenen FaktenWartet auf Ihr OK
Antworten in Ihrem Ton, aus Ihren Preisen
Eine Anfrage kommt nachts an. Am Morgen wartet eine Antwort auf Basis Ihrer eigenen Preisliste und freigegebener Fakten auf Sie.
Quelle
Ihre Preisliste und freigegebene Textbeispiele
Eine Person
Bearbeitet und verschickt. Der Entwurf verschickt sich nie selbst
2 neue Anfragen, Antworten entworfen. Senden?OpenClaw, über Ihr ModellSie entscheidenn8n: neue E-Mail, Ihr Modell, CRM aktualisiert
Agenten für die Routineschritte
OpenClaw, Hermes Agent und n8n nutzen das Modell für Routineschritte: sortieren, entwerfen, den Datensatz aktualisieren und vor dem riskanten Schritt nachfragen.
Quelle
Ihr Postfach, Kalender und CRM, mit Berechtigungen
Eine Person
Gibt Senden, Buchen und Ausgaben frei
Sehen, wo die Arbeit läuft.
Ein Firmenserver kann das ausgewählte Modell, den Wissensindex und die Ablaufsteuerung bereitstellen. Ihr Team greift über eine vereinbarte Oberfläche darauf zu.
Ihr TeamEine berechtigte Anfrage aus der internen Oberfläche.
UnternehmenswissenFreigegebene Dokumente und zugriffsgesteuerter Wissensabruf.
Lokaler ModellserverEin kompatibles Modell läuft über Ollama oder vLLM.
Geprüfte AusgabeAnwendungsvalidierung, menschliche Prüfung und erlaubte Werkzeuge.
Was liegt wo?
Dokumente + Suchindex
Firmenspeicher und ein zugriffsgesteuerter Index auf dem gewählten Server.
Modellgewichte + Adapter
Versionierte Dateien auf dem Ausführungsrechner. Nur freigegebene Versionen werden geladen.
Trainingsbeispiele
Ein separater, geschützter Datensatz. Der Trainingsort wird vor der Übertragung vereinbart.
Protokolle + Sicherungen
Benannter Speicher, begrenzter Zugriff und vereinbarte Aufbewahrung. Sensible Felder können ausgeschlossen werden.
Ausgehende Verbindungen
Für jedes externe Werkzeug werden Ziel, übertragene Felder und Zweck aufgeführt.
Eine Workstation eignet sich für eine vereinbarte kleine Arbeitslast. Ein Firmenserver ermöglicht gemeinsamen Zugriff. Eine hybride Einrichtung ergänzt nur die von Ihnen freigegebenen externen Dienste.
Lokaler Betrieb
Modellausführung und vereinbarter Wissensspeicher bleiben auf Ihrer gewählten Hardware, mit abgeschalteten Cloud-Modellen der Laufzeitumgebung. Netzwerkzugriff, Updates, Protokolle und Sicherungen müssen trotzdem ausdrücklich eingerichtet werden.
Eine dokumentierte hybride Einrichtung
Ein lokaler Ablauf kann ein externes Modell, einen E-Mail-Dienst oder ein CRM verwenden. Wir zeigen, welche Felder den Server verlassen, wohin sie gehen und ob ein Ausweichdienst aktiviert ist.
Quellenberechtigungen, Speicherung, Aufbewahrung, Protokollierung und Betreiberzugriff werden vor der Anbindung von Geschäftsdaten vereinbart. Eine lokale Installation allein garantiert keinen durchgehend privaten Ablauf.
Vier Wege, wie ein Modell für Sie arbeiten kann.
Die meisten Einrichtungen kombinieren zwei oder drei. Wir testen zuerst die einfachste, die die Aufgabe erfüllt.
Ihr ServerModell
Ein Modell auf Ihrer Hardware betreiben
Das Modell antwortet auf Ihrer Workstation oder Ihrem Firmenserver.
Verändert das Modell
Nein
Nutzt
Ihre Anfrage und Anweisungen
Geeignet für
Entwürfe, Zusammenfassungen, Sortierung
ModellQuelle
Freigegebenes Firmenwissen anbinden
Passende Textstellen werden bei jeder Frage nachgeschlagen. Die Antwort nennt ihre Quelle.
Verändert das Modell
Nein
Nutzt
Freigegebene Dokumente und ein Suchindex
Geeignet für
Aktuelle Richtlinien, Produktfakten
AdapterModell
Für eine klar definierte Aufgabe feinjustieren
Kuratierte Beispiele vermitteln Format, Ton oder Kategorien. Fakten kommen weiter aus Dokumenten.
Verändert das Modell
Ja, über einen getesteten Adapter
Nutzt
Freigegebene Trainingsbeispiele
Geeignet für
Ein einheitliches Ausgabeformat
ModellSie geben freiCRM
Erlaubte Geschäftswerkzeuge anbinden
Das Modell darf die freigegebenen Werkzeuge nutzen, etwa Kalender oder CRM. Riskante Aktionen warten auf eine Person.
Verändert das Modell
Nein
Nutzt
Werkzeugrechte und eine Freigaberegel
Geeignet für
Den nächsten Schritt vorbereiten
Ein lokal betriebenes Modell rechnet auf Ihrer Hardware. Ob der gesamte Ablauf privat bleibt, hängt von jedem angebundenen Werkzeug ab. Diese listen wir vor der Einrichtung auf.
Klein anfangen. Wachsen, wenn es funktioniert.
Drei Wege, die Arbeit zu gliedern. Es sind keine festen Pakete oder Preise.
1
Bewerten
Eine nützliche Aufgabe wählen und passende Modelle daran testen.
Aufgabe und gutes Ergebnis festlegen
Mögliche Modelle mit Ihren freigegebenen Beispielen testen
Qualität, Geschwindigkeit, Lizenz und Hardwarebedarf vergleichen
Das Modell wird ausgewählt, nicht pauschal versprochen.
Welches Modell passt?
Gemma 4, Qwen3.5 bis 3.8 und gpt-oss sind die Modellfamilien, die wir zuerst testen. DeepSeek-R1 und Llama 3.1 sind bekannte Alternativen mit eigenen Lizenzhinweisen. Keine davon ist eine pauschale Empfehlung. Wir vergleichen Aufgabenqualität auf Deutsch und Englisch, Lizenz, unterstützte Werkzeuge, Modellgröße und Speicherbedarf auf Ihrer Hardware. Die Übergabe nennt das konkret getestete Modell, Format und die Quantisierung.
Training oder Unternehmenswissen?
Fine-Tuning verändert Modellverhalten anhand von Beispielen. Retrieval-Augmented Generation (RAG) liefert passende Dokumente bei einer Anfrage. Wir beginnen mit einer Ausgangsversion und wählen anhand der Ergebnisse Anweisungen, Wissensabruf, Anpassung oder eine Kombination.
Was wird eingerichtet?
Modell- und Adapterversionen, Anweisungen, Kontextgrenzen, Ausgabeformate, erlaubte Werkzeuge, Quellenzugriff und Protokollierung. SFT mit LoRA oder QLoRA kann ein geeignetes Modell anpassen, wenn kuratierte Beispiele ein Training rechtfertigen. Evaluationsdaten bleiben von Trainingsdaten getrennt.
Wo findet das Training statt?
Training und tägliche Inferenz können unterschiedliche Hardware benötigen. Wir vereinbaren die Vorbereitung der Trainingsdaten, den Ausführungsort des Trainings und die Übertragung des Modells oder Adapters auf Ihren Server. Cloud-Training oder ein externes Ausweichmodell sind durch das Wort lokal nicht automatisch eingeschlossen.
Wie wird das Ergebnis geprüft?
Ausgangsversion und angepasste Einrichtung anhand zurückgehaltener Aufgaben vergleichen. Antworten, Quellenbezug, Ausgabeschemata, Werkzeugwahl, Fehlerbehandlung, Antwortzeit und Ressourcennutzung prüfen. Auch ein kleineres oder quantisiertes Modell muss die vereinbarte Qualität erreichen.
Sinken dadurch API-Kosten?
Lokale Inferenz kann bei geeigneten Aufgaben laufende Modell-API-Nutzung reduzieren. Wir vergleichen Hardware, Einrichtung, Training, Strom und Wartung mit der erwarteten API-Nutzung. Verbundene Cloud-Werkzeuge können weiterhin Gebühren verursachen. Einsparungen hängen von Volumen, Modellqualität und Auslastung ab.
Eine getestete Modellempfehlung und dokumentierte Konfiguration.
Den vereinbarten lokalen Endpunkt, Wissensverbindungen und Ablaufkontrollen.
Evaluationsergebnisse, Betriebsanleitung, Sicherungen und Updatezuständigkeiten.
Ihr Team stellt bereit
Eine konkrete Aufgabe und Beispiele, die Sie verwenden dürfen.
Repräsentative Testfälle, gewünschte Ausgaben und Quellenzugriffsregeln.
Verfügbare Hardware, erwartetes Volumen und eine für den Betrieb verantwortliche Person.
Passende Umsetzungserfahrung
Unser Portfolio enthält lokale Agenteninstallation und die Prüfung von Hardwaregrenzen. Dieser Nachweis ist von Fine-Tuning eines Kundenmodells getrennt.